Hedy, iPhone과 Mac에 NVIDIA Nemotron 3 Diarization 도입
Hedy 3.12는 iPhone과 Apple Silicon Mac에 NVIDIA의 Nemotron 3 Diarization을 도입합니다. 세션이 끝나면 기기에서 직접 실행되어 누가 어떤 말을 했는지 정리합니다.
NVIDIA는 오늘 자사의 화자 구분 모델 중 가장 성능이 뛰어난 Nemotron 3 Diarization을 공개했습니다. Hedy는 공개 첫날부터 iPhone과 Mac용 Hedy 3.12에서 이 모델을 지원합니다. 저희가 지금까지 본 화자 구분 모델 중 가장 정확하며, 기기에서 직접 실행되므로 회의가 끝난 뒤 누가 어떤 말을 했는지 담긴 기록을 더 신뢰할 수 있습니다.
화자 레이블은 녹취록을 대화로 만들어 줍니다. 레이블이 어긋나면 한 사람의 발언이 다른 사람의 말로 기록되고, 요약에서도 같은 실수가 반복됩니다. 이 모델은 바로 그 문제를 해결하기 위해 만들어졌습니다.
Nemotron 3 Diarization은 어떤 일을 하나요?
화자 구분은 녹음에서 누가 언제 말했는지를 파악합니다. 오디오를 화자별로 나누고 각 화자가 말하는 구간을 표시합니다. 말을 텍스트로 변환하는 일이나 사람의 이름을 파악하는 일은 각각 별개의 작업입니다.
Nemotron 3 Diarization은 이 작업을 위한 NVIDIA의 최신 모델입니다. 대화가 진행되는 동안 각 화자의 레이블을 안정적으로 유지하는 NVIDIA의 Streaming Sortformer 연구를 바탕으로 합니다. NVIDIA의 모델 문서에 따르면 다음과 같은 특징이 있습니다.
- 회의, 전화 통화, 팟캐스트 등 대화 오디오로 학습했습니다.
- 두 사람이 동시에 말하는 순간처럼 발화가 겹치는 상황을 처리합니다.
- 하나의 녹음에서 최대 8명의 화자를 추적할 수 있습니다.
- 처음 말한 순서대로 화자에게 레이블을 붙이므로 첫 번째 목소리는 화자 1이 됩니다.
- 약 1억 개의 매개변수를 가진 소형 모델이어서 휴대폰에서도 실행할 수 있습니다.
공개된 벤치마크 2개에서는 클라우드 서비스도 앞섰습니다. NVIDIA의 출시 발표 글에 따르면, 이 모델은 화자 구분 오류율(발화 시간 중 레이블이 잘못 붙은 시간의 비율) 14.72%로 VoiceArena의 화자 구분 순위표에서 1위를 차지했으며, 그다음 시스템의 오류율은 19.3%였습니다. Argmax가 공개한 벤치마크에서는 Mac에서 실행하면서도 테스트한 시스템 6개 중 오류율이 가장 낮았습니다. 이 중 3개는 클라우드 화자 구분 서비스였습니다.
NVIDIA는 테스트한 모든 벤치마크에서 이전 화자 구분 모델보다 성능이 개선되었다고도 보고했습니다. 특히 4명 넘게 대화할 때 격차가 더 커졌습니다. 이는 기존의 화자 레이블 기능이 대체로 어려움을 겪던 상황입니다.
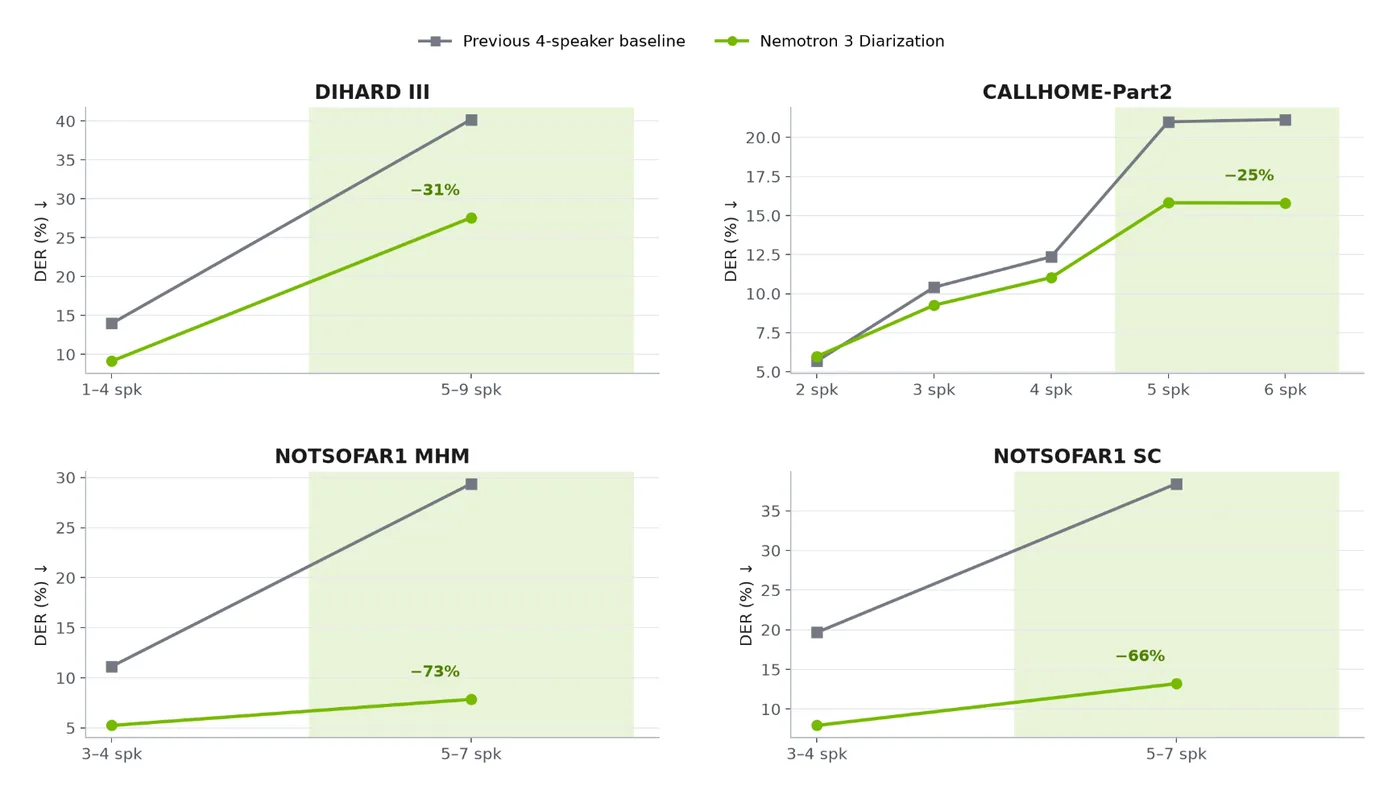
차트: NVIDIA의 Nemotron 3 Diarization 출시 발표 글에서 발췌. 낮을수록 좋으며, 음영 영역은 화자가 4명 넘는 구간입니다. NVIDIA는 전체 평가 결과와 함께 Hugging Face에 모델을 공개하고 있습니다.
Nemotron 3 Diarization으로 Hedy에서는 무엇이 달라지나요?
Hedy는 이미 Nemotron 음성 엔진을 사용해 대화 중 화자 레이블을 붙이고 있습니다. 이 실시간 레이블은 그대로 유지됩니다.
새로운 기능은 세션을 종료한 뒤에 작동합니다. 실시간 레이블은 그 순간에 결정해야 하므로, 이제 Hedy는 대화가 끝나면 한 번 더 살펴봅니다. 세션에 Nemotron 3 Diarization을 실행해 녹취록의 각 부분이 어느 화자의 발언인지 업데이트합니다.
이 과정에서는 화자 배정만 수정합니다. 녹취록의 모든 단어와 타임스탬프는 그대로 유지됩니다. 처리가 끝나면 녹취록 위의 화자 칩을 지금과 똑같이 사용할 수 있습니다. 칩을 눌러 해당 화자에게 이름을 붙이거나, 같은 사람으로 확인된 칩 2개를 병합하세요.
Nemotron 3 Diarization은 기기에서 직접 실행되나요?
Hedy는 실시간으로 대화를 들으며 회의를 지원하고 대화의 개인정보를 보호하는 것을 목표로 합니다. 음성 인식이 기본적으로 기기에서 직접 실행되는 이유도, 화자 레이블을 붙이는 작업을 기기에서 처리하는 이유도 여기에 있습니다.
Nemotron 3 Diarization도 같은 원칙을 따릅니다. 이만큼 성능이 뛰어난 모델이 휴대폰에서 실행할 수 있을 정도로 작다는 점이 반갑습니다. Apple의 Core ML을 통해 iPhone이나 Mac에서 실행되며, 누가 말했는지 파악하기 위해 오디오를 클라우드 서비스로 보내지 않습니다. 세션이 끝난 뒤 이 작업을 수행할 수 있도록 Hedy는 세션 오디오를 기기의 임시 캐시에 보관하고 처리가 끝나면 삭제합니다. 음성 인식 가이드에서 이 캐시와 관련 설정을 설명합니다.
요약과 메모를 작성하는 AI 단계는 별도로 선택할 수 있습니다. 로컬 AI 처리를 사용하면 이 단계도 기기에서 직접 처리할 수 있습니다.
어떤 기기에서 Nemotron 3 Diarization을 지원하나요?
Nemotron 3 Diarization은 Hedy 3.12 이상이 설치된 지원 대상 iPhone과 Apple Silicon Mac에서 실행됩니다. Windows와 Android의 Hedy는 현재의 화자 레이블을 유지합니다.
Hedy 3.12는 앞으로 24시간 동안 순차적으로 배포되므로 Hedy에서 업데이트를 확인하세요. 업데이트한 뒤에는 설정 → 음성 및 AI를 열고 Hedy가 안내하는 음성 모델 업데이트를 설치하세요.
이 기능은 Hedy에서 화자를 구분하는 Nemotron 음성 엔진으로 캡처한 세션에 적용됩니다. 현재 Whisper나 클라우드 음성 서비스를 사용하고 있다면, 같은 설정 화면에서 Nemotron으로 전환해 실시간으로도, 세션이 끝난 뒤에도 화자 레이블을 사용할 수 있습니다.
자주 묻는 질문
Nemotron 3 Diarization이란 무엇인가요?
NVIDIA의 화자 구분 모델입니다. 화자 구분은 녹음에서 누가 언제 말했는지 파악하는 단계입니다. Nemotron 3 Diarization은 회의나 통화 같은 대화용으로 개발되었으며, 여러 사람이 겹쳐 말하는 상황을 처리하고 최대 8명의 화자를 추적할 수 있습니다.
Nemotron 3 Diarization의 정확도는 어느 정도인가요?
NVIDIA에 따르면, 화자 구분 오류율 14.72%로 VoiceArena의 화자 구분 순위표에서 1위를 차지했으며, 그다음 시스템의 오류율은 19.3%였습니다. Argmax가 공개한 벤치마크에서는 클라우드 화자 구분 서비스 3개를 포함해 테스트한 시스템 6개 중 오류율이 가장 낮았습니다. 화자 구분 오류율은 발화 시간 중 잘못된 화자에게 배정되거나, 누락되거나, 발화로 잘못 판정된 시간의 비율이므로 낮을수록 좋습니다.
실시간 세션 중의 화자 레이블도 바뀌나요?
아니요. 세션이 진행되는 동안 표시되는 실시간 레이블은 지금과 같은 방식으로 작동합니다. Nemotron 3 Diarization은 세션이 끝난 뒤에 작동합니다.
기기에서 직접 실행되나요?
네. 이 모델은 Apple의 Core ML을 통해 iPhone이나 Mac에서 실행됩니다. 누가 말했는지 파악하기 위해 오디오를 클라우드 서비스로 보내지 않습니다.
어떤 세션에 적용되나요?
Nemotron 음성 엔진으로 캡처한 세션에 적용됩니다. 모델이 세션 오디오를 읽으므로 해당 오디오가 기기에 있어야 합니다. 오디오 녹음 또는 Nemotron용 임시 오디오 캐시가 켜져 있어야 합니다. 캐시는 기본적으로 켜져 있으며 처리가 끝나면 삭제됩니다.
사람들의 이름도 알 수 있나요?
아니요. 모델은 목소리를 구별해 화자 1, 화자 2 같은 레이블을 붙입니다. 이름은 계속 Hedy가 파악합니다. 자기소개, 캘린더 초대, 토픽 컨텍스트에서 이름을 가져오고, 직접 입력한 이름도 사용합니다.
어떤 기기에서 지원되나요?
Hedy 3.12 이상을 실행하는 지원 대상 iPhone과 Apple Silicon Mac에서 지원됩니다. Windows와 Android의 Hedy는 현재의 화자 레이블을 유지합니다.
About the author
Julian Pscheid is the founder and CEO of Hedy AI, a real-time AI meeting coach used by tens of thousands of professionals worldwide. He writes about how AI is changing the way people prepare for, capture, and understand important conversations.