회의 AI를 전부 기기에서 실행하기: Hedy 3.2의 모델과 속도 차이
Hedy 3.2의 기기 내 AI를 기술적으로 살펴봅니다. 어떤 모델을 선택했는지, Mac, Windows, iPhone에서 어떻게 실행되는지, 로컬 추론이 속도에 어떤 영향을 주는지 설명합니다.
Hedy 3.2에서는 회의의 모든 처리 과정을 노트북에서 실행할 수 있습니다. 오디오, 음성 텍스트 변환, 요약, 메모, 제안까지 모두 기기 안에서 처리되며 회의 데이터는 기기 밖으로 나가지 않습니다. 기본값은 여전히 클라우드이며, 대부분의 사용자에게도 클라우드가 적합합니다. 로컬 모드는 속도가 조금 느려지더라도 대화 데이터를 자기 기기에 두고 싶은 분을 위한 선택입니다. 최고 사양의 기기에서는 속도를 양보할 필요가 없을 때도 있습니다. 두 방식의 장단점을 있는 그대로 설명하고도 출시할 만하다고 판단한 건 이번이 처음입니다.
Hedy는 Mac, Windows, iOS, Android, 웹에서 약 30,000명이 사용하는 회의 코치입니다. 음성 인식은 처음부터 모든 플랫폼에서 기기 내에서 실행됐습니다. 요약, 자세한 메모, 세션 중 채팅, ‘다음에 무슨 말을 하면 좋을까?’에 답하는 실시간 제안을 담당하는 AI 분석은 줄곧 클라우드에서 실행됐습니다. 3.2에서 달라진 부분입니다.
이 글에는 2026년에 이 변화가 가능해진 배경, 저희가 고른 모델, 그리고 의도적으로 구현하지 않은 기능을 담았습니다. 개인정보 보호, 변호사·환자·기자의 활용 사례, 기능을 켜는 방법 등 회의에서 로컬 AI를 어떻게 쓸 수 있는지 알아보려면 회의용 로컬 AI 소개를 읽어 보세요.
두 곡선의 교차
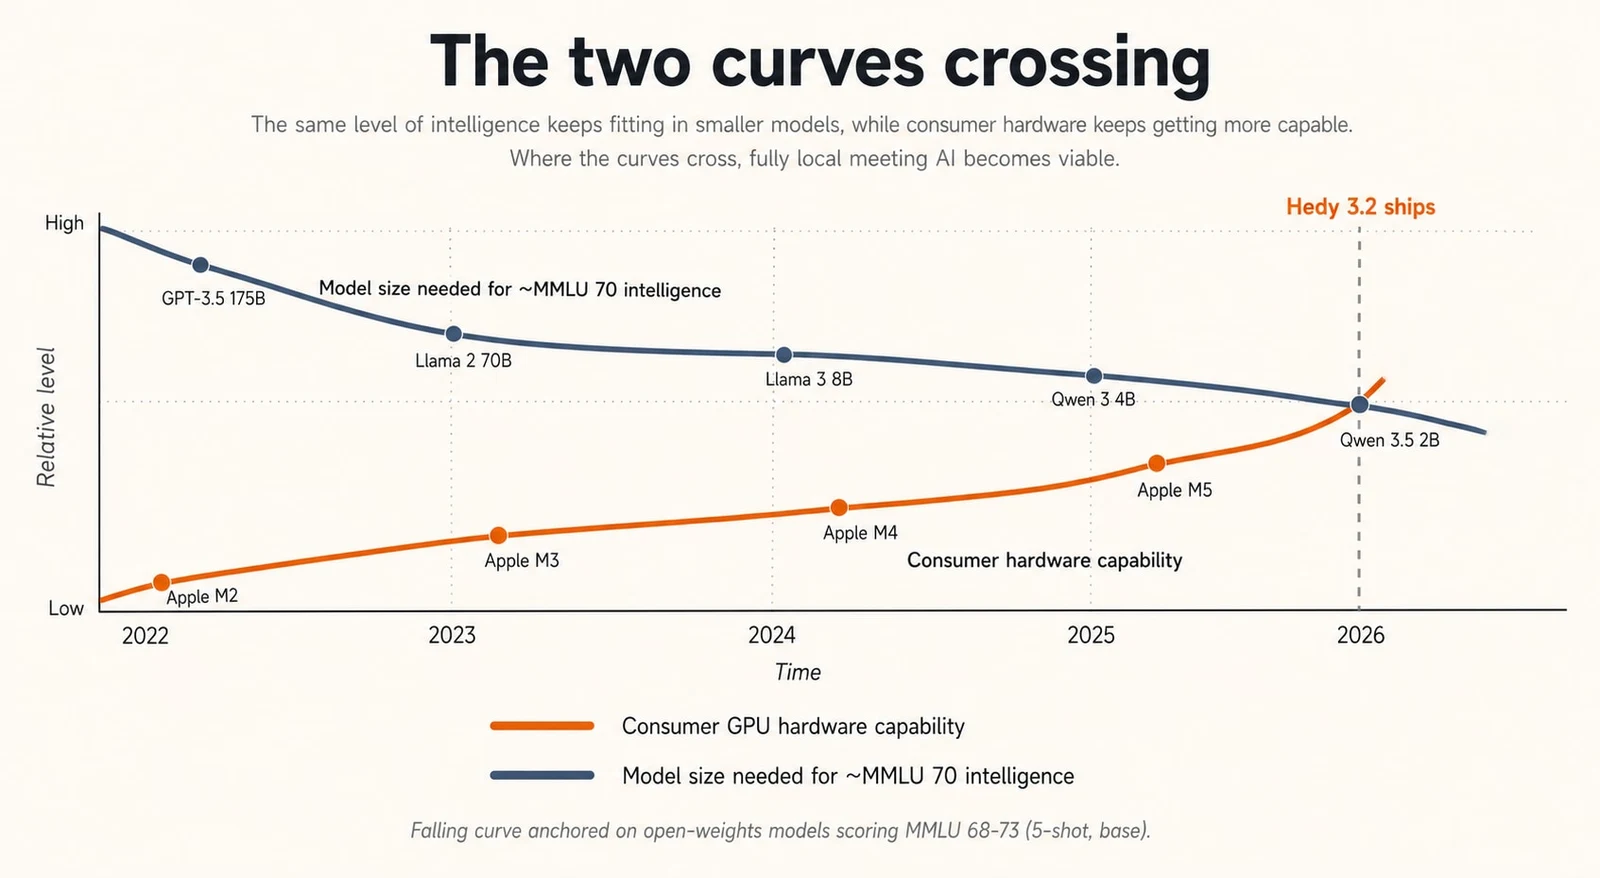
저희는 몇 년 동안 두 가지 추세를 지켜봤습니다.
첫 번째는 가중치 공개 모델의 품질입니다. 2023년 중반의 Llama 2는 챗봇 데모를 넘어서는 용도로는 흥미로운 실험에 가까웠습니다. 2024년 말에는 Llama 3와 Qwen 2.5가 작은 크기에서도 실용적인 수준에 이르렀습니다. 그래도 30분 동안 여러 사람이 주고받은 대화에서 누구의 발언인지 추적하며 회의를 요약하는 작업에서는 성능 차이가 느껴졌습니다. 2025년부터 2026년 초까지 저희 용도에 특히 잘 맞는 두 모델 계열이 앞서 나갔습니다. Google의 Gemma 4와 Alibaba의 Qwen 3.5/3.6입니다. 두 팀 모두 파라미터 수 대비 성능을 높이는 데 상당한 노력을 들였습니다. 두 계열을 합치면 기기 내에서 실행되는 2B급 모델부터 35B MoE까지 아우릅니다. 여러 크기의 모델이 지시 이행과 구조화된 출력에서 크기 이상의 성능을 냅니다.
두 번째는 일반 소비자용 하드웨어입니다. Apple Silicon의 통합 메모리 구조는 트랜스포머 추론에 잘 맞습니다. GPU 연산에 쓰이는 메모리에 모델 가중치가 있으므로 PCIe를 오가는 전송이 없고, 별도로 VRAM 용량을 따질 필요도 없습니다. M3 세대에 이르러서는 RAM 16GB의 기본 사양 MacBook Air에서도 양자화한 89B 모델을 실용적인 속도로 실행할 수 있었습니다. Windows는 다른 경로를 밟았습니다. 게임이나 콘텐츠 제작용으로 판매되는 기기에는 VRAM 812GB를 갖춘 독립형 GPU가 흔합니다. 이제 Vulkan 기반 추론 프레임워크는 NVIDIA, AMD, 그리고 점점 더 많은 Intel 하드웨어에서 성능을 대부분 끌어낼 수 있습니다.
두 곡선은 2026년 초에 교차했습니다. 필요한 작업을 잘 해내는 모델을 고를 수 있게 됐고, 이미 사용자들이 보유한 소비자용 하드웨어에서 그 모델을 실행할 수 있었습니다. 그래서 출시했습니다.
모델 선정과 그 이유
기반 런타임은 llama.cpp입니다. 서브모듈로 포함하고 플랫폼마다 맞는 백엔드로 빌드합니다. GGUF로 양자화된 가중치는 Unsloth의 HuggingFace 빌드에서 가져옵니다. 현재 이 크기 범위에서 잘 양자화된 가중치 공개 모델을 구하기에 가장 좋은 곳입니다.
출시 시점에 제공하는 모델은 다음과 같습니다.
| 모델 | 양자화 | 파일 크기 | 로드 시 RAM | 품질 |
|---|---|---|---|---|
| Qwen 3.5 2B | Q4_K_M | 1.2 GB | 3 GB | ★ |
| Qwen 3.5 4B | Q4_K_M | 2.6 GB | 4.5 GB | ★ |
| Gemma 4 E2B | Q4_K_M | 2.9 GB | 5 GB | ★ |
| Gemma 4 E4B | Q4_K_M | 4.6 GB | 7 GB | ★★ |
| Qwen 3.5 9B | Q4_K_M | 5.3 GB | 8 GB | ★★ |
| Qwen 3.5 9B HQ | Q8_0 | 8.9 GB | 12 GB | ★★ |
| Qwen 3.6 27B | UD-Q4_K_XL | 17.6 GB | 22 GB | ★★★ |
| Gemma 4 31B | Q4_K_M | 17.1 GB | 23 GB | ★★★ |
| Qwen 3.6 35B-A3B | UD-Q4_K_M | 20.6 GB | 25 GB | ★★★ |
보관 처리한 이전 버전도 몇 가지 있습니다. 이미 다운로드한 사용자는 계속 선택할 수 있으며, 기기에서 파일을 삭제하면 모델 선택 목록에서 사라집니다. 모델 선택 화면에서는 품질을 별 세 단계로 표시합니다. 7B 미만은 별 하나, 7~12B는 별 두 개, 12B 초과는 별 세 개입니다. 양자화가 Q4인지 Q8인지에 따라 등급이 달라지지는 않습니다. 별은 배포된 가중치의 정밀도와 별개로 모델 자체의 역량을 나타냅니다.
Gemma 4 E2B와 E4B 앞의 ‘E’는 Google이 ‘유효 파라미터’를 나타내는 표기입니다. E2B의 유효 파라미터는 약 2.3B이고 임베딩까지 포함하면 약 5.1B입니다. E4B의 유효 파라미터는 약 4.5B이고 임베딩을 포함하면 약 8B입니다. Qwen은 전체 파라미터 수를 그대로 표기합니다. 모델 선택 화면은 사용자가 실제로 중요하게 보는 로드 시 RAM과 품질 등급을 기준으로 정렬하므로, 두 가지 이름 표기 방식이 섞여도 혼동을 줄일 수 있습니다.
Gemma 4와 Qwen 3.5/3.6을 고른 데에는 공통된 이유가 있습니다. 필요한 범위 안에 여러 크기가 있고, 작은 모델도 지시를 잘 따릅니다. 회의 요약은 대부분 “이 출력 스키마를 따르고 없는 내용을 지어내지 마세요”라는 작업이므로 이 점이 중요합니다. 두 계열 모두 상업적 배포를 허용하는 라이선스를 사용하며, Hedy가 현재 인터페이스를 제공하는 51개 언어에서 토크나이저가 잘 작동합니다. 27B Qwen 모델은 Unsloth의 UD-Q4_K_XL(“Unsloth Dynamic”) 양자화를 사용합니다. 중요한 레이어의 가중치 정밀도를 더 많이 보존하기 때문에, 같은 파일 크기의 일반적인 Q4보다 품질 차이가 뚜렷합니다.
앱의 모델 선택 화면에는 현재 기기와 호환되는 모델이 디스크 용량, 로드 시 예상 RAM, 품질 등급과 함께 표시됩니다. 실행은 가능하지만 하드웨어 여건상 레이어 일부를 CPU로 넘겨야 하는 모델에는 ’ + 느림’이 붙습니다. 5GB를 다운로드하고 나서야 요약에 4분이 걸린다는 사실을 알게 되기보다, 선택할 때 미리 알 수 있게 했습니다.
직접 준비한 모델 사용. 모델 선택 화면의 ‘사용자 정의 모델’ 섹션에서는 디스크에 있는 호환 GGUF 파일을 Hedy에 지정해 목록에 있는 다른 모델과 함께 사용할 수 있습니다. Hedy는 파일을 복사하지 않습니다. 파일은 원래 위치에 그대로 있고, 앱을 다시 실행해도 연결이 유지되도록 Hedy가 파일 참조를 저장합니다. 호환성은 보장하지 않습니다. llama.cpp가 로드할 수 있는 GGUF여야 하고, 채팅 템플릿은 Hedy의 프롬프트로 쓸 만한 구조화된 출력을 생성할 수 있어야 합니다. 메모리 사용량도 직접 계산해야 합니다. 이 문단을 읽고 “DeepSeek V4를 돌려 볼 수 있겠는데?”라는 생각이 들면 시도해 보세요.
Apple Silicon에서 실행이 쉬운 이유
Apple Silicon에서 기기 내 AI를 실행해 보면 미래가 벌써 온 듯합니다. 세 가지가 이를 가능하게 합니다.
첫째는 통합 메모리 구조입니다. GPU와 CPU가 같은 RAM을 공유합니다. 양자화한 8B 파라미터 모델을 메모리에 올리면 GPU가 메모리 대역폭을 그대로 활용해 가중치를 읽을 수 있습니다. Windows의 독립형 GPU 구성에서 일반적으로 드는 VRAM 복사 비용이 없습니다. 토큰 하나를 처리할 때마다 가중치를 수천 번 연산 장치로 보내는 추론에서는 구조적으로 큰 이점입니다.
둘째는 Metal입니다. Apple의 GPU 연산 API는 성숙했고 문서도 잘 갖춰져 있습니다. llama.cpp의 Metal 백엔드는 특히 완성도가 높습니다. 저희는 GGML_METAL=ON으로 컴파일하며 별다른 추가 작업은 하지 않습니다.
셋째는 M-series 칩의 기본 성능입니다. 기본형 M1도 GPU 성능과 메모리 대역폭이 충분해 작은 양자화 모델을 대화형 작업에 쓸 수 있는 속도로 실행합니다.
실제로 모델별 실행 가능 여부는 다음과 같습니다.
| 모델 | 품질 | 로드 시 RAM | 8 GB | 16 GB | 24 GB | 32 GB | 64 GB+ |
|---|---|---|---|---|---|---|---|
| Qwen 3.5 2B | ★ | 3 GB | ● | ● | ● | ● | ● |
| Qwen 3.5 4B | ★ | 4.5 GB | ● | ● | ● | ● | ● |
| Gemma 4 E2B | ★ | 5 GB | ◐ | ● | ● | ● | ● |
| Gemma 4 E4B | ★★ | 7 GB | — | ● | ● | ● | ● |
| Qwen 3.5 9B | ★★ | 8 GB | — | ● | ● | ● | ● |
| Qwen 3.5 9B HQ | ★★ | 12 GB | — | ◐ | ● | ● | ● |
| Qwen 3.6 27B | ★★★ | 22 GB | — | — | ◐ | ● | ● |
| Gemma 4 31B | ★★★ | 23 GB | — | — | ◐ | ● | ● |
| Qwen 3.6 35B-A3B | ★★★ | 25 GB | — | — | — | ◐ | ● |
● 메모리 여유 있음 · ◐ 메모리 빠듯함(로드는 가능하지만 긴 회의 중 운영체제에 메모리 부담을 주며, 모델 선택 화면에 ' + 느림'이 표시됨) · — 로드 불가
표만으로는 알 수 없는 점도 있습니다. 별 하나짜리 모델은 구조화된 출력과 짧은 요약에는 강하지만, 화자가 많은 긴 회의에는 약합니다. 별 두 개짜리 Gemma 4 E4B와 Qwen 3.5 9B는 기본 사양 MacBook Air를 쓰는 분을 포함해 대부분의 사용자에게 적합합니다. 저희가 하는 작업에서는 호스팅되는 소형 최첨단 모델에 근접하는 성능을 냅니다. Qwen 3.5 9B HQ는 파라미터 수가 같고 양자화가 Q4에서 Q8로 바뀐 버전입니다. 파라미터 등급을 한 단계 올릴 때만큼 품질이 크게 좋아지지는 않지만, 메모리 여유가 있으면 차이를 느낄 수 있습니다. 35B-A3B는 MoE 모델입니다. 파라미터는 총 35B지만 토큰마다 약 3B만 활성화되므로 크기에 비해 추론이 빠릅니다.
가장 반가운 결과는 기본 사양 MacBook Air에서도 별 두 개짜리 모델이 잘 돌아갔다는 점입니다. 저희는 로컬 AI가 고급 사용자용이라고 안내할 각오를 하고 있었지만, Apple Silicon에서는 그렇게 말할 필요가 없었습니다.
Windows의 VRAM과 CPU 오프로딩 문제
Windows는 더 복잡합니다. 하드웨어 편차가 큽니다. 최신 게이밍 데스크톱에 4080을 장착한 개발자는 Hedy가 지원하는 어떤 Mac보다도 높은 추론 성능을 누릴 수 있습니다. 반면 내장 그래픽만 있는 업무용 노트북에서는 추론에 쓸 만한 성능을 사실상 기대하기 어렵습니다.
Windows 빌드에는 한 가지 조건을 뒀습니다. 로컬 AI에는 Vulkan이 필요합니다. 빌드 시 Vulkan SDK가 있으면 Windows CMake 빌드에서 GGML_VULKAN=ON을 설정하고, 없으면 llama.dll 대상을 아예 빌드하지 않습니다. Windows의 로컬 AI에는 CPU만 사용하는 대체 경로가 없습니다. NVIDIA에서는 CUDA가 더 빠르겠지만, GPU 제조사 하나에 종속되면 AMD와 Intel 사용자는 모두 기능을 쓸 수 없습니다. Vulkan은 NVIDIA에서 CUDA에 근접한 성능을 내고, 실제 Hedy 사용자들이 쓰는 여러 제조사의 GPU에서 작동하는 유일한 경로입니다.
Windows에서는 Mac과 메모리 구조가 다릅니다. 독립형 GPU는 시스템 RAM과 별도의 VRAM을 갖고 있으며, 모델 전체가 VRAM에 들어가야 GPU 가속을 온전히 활용할 수 있습니다. 모델이 조금 크면 llama.cpp가 레이어를 나눌 수 있습니다. 대부분은 GPU에 올리고 나머지는 CPU에서 실행합니다. 작동은 하지만 토큰마다 가장 느린 레이어를 기다려야 합니다. 모델 전체가 VRAM에 들어가는 상태에서 레이어 두 개만 CPU로 옮겼는데도 처리량이 거의 절반으로 줄어드는 사례를 봤습니다. CPU로 넘어가는 레이어가 몇 개를 넘어서면 차라리 CPU에서 실행하는 것과 다를 바가 없습니다.
레이어를 어디에 둘지 정확히 계산해야 합니다. 카탈로그에는 각 모델의 numLayers가 기록돼 있습니다. Qwen 2B는 24개, Qwen 4B는 32개이며, 각 모델의 HuggingFace config.json에서 확인한 값입니다. llama.cpp의 n_gpu_layers에 실제보다 훨씬 큰 값을 넘겨도 이득이 없습니다. llama.cpp는 오프로딩을 실제 레이어 수로 제한하고, 부풀린 값으로 메모리 적합성이나 CPU로 넘어갈 레이어 수를 계산하면 오류가 드러나지 않은 채 결과가 틀어집니다. 그래서 카탈로그에는 실제 레이어 수를 기록합니다.
모델 선택 화면에서는 예상 결과를 구체적으로 보여 줍니다. 사용 가능한 VRAM을 확인하고 가중치, KV 캐시, 작업 버퍼를 합쳐 모델에 필요한 메모리 용량을 계산한 뒤 다음과 같이 처리합니다.
- 모델이 VRAM에 들어가면 목록에 일반 항목으로 표시합니다.
- 일부 레이어만 CPU로 넘어가면 ’ + 느림’을 붙여 체감할 만한 지연이 생긴다는 사실을 알립니다.
- 너무 많은 레이어를 CPU로 넘겨야 하면 해당 하드웨어의 목록에 모델을 표시하지 않습니다.
GPU가 감지되지 않거나 가장 작은 모델을 실행할 메모리도 부족하면, ‘설정’의 ‘로컬 AI’ 섹션에 모델 목록 대신 사용할 수 없는 이유가 표시됩니다.
일부 Windows 빌드에서는 NVIDIA 595.xx 드라이버가 RTX 40 시리즈 카드로 Vulkan 연산을 할 때 모델 로드 중 FAST_FAIL 충돌을 일으키는 알려진 문제가 있었습니다. 처음에는 Hedy의 버그라고 생각해 조사했지만, 같은 드라이버 버전을 쓰는 다른 Vulkan 애플리케이션에서도 동일한 충돌 패턴이 나타났습니다. 이 문제는 NVIDIA의 596.21 드라이버에서 수정됐습니다. 이제 Hedy는 더 명확한 오류 메시지를 표시하지만, 문제를 해결하려면 드라이버를 업데이트하세요.
모바일의 가장 작은 모델 등급과 성능 차이
로컬 AI는 A17 Pro 칩 이상을 탑재한 iPhone 15 Pro 이후 기기와 M-series 또는 A17 Pro 칩을 탑재한 iPad에서만 활성화했습니다. 그보다 오래된 기기는 통합 메모리 용량이나 Neural Engine 세대의 한계 때문에 가장 작은 등급의 모델조차 실용적인 속도로 실행하기 어렵습니다.
iPhone 15 Pro에서도 Compact 등급의 Qwen 3.5 2B, Qwen 3.5 4B, Gemma 4 E2B를 실행합니다. 양자화한 2~5B 파라미터 모델과 9B 모델은 글을 쓰는 역량에서 차이가 납니다. 작은 모델은 구조화된 출력을 만들고 명확한 지시를 따르는 데 강하며 짧은 요약도 무난합니다. 회의가 길어지면 대화의 흐름을 놓치기 쉽고, 특히 화자가 많거나 전문 용어가 나오는 회의에서 그렇습니다. 모바일 화면에는 로컬 모델이라는 점을 명시합니다. 휴대전화에서 본격적으로 회의를 분석할 때는 클라우드 AI를 기본으로 권장합니다.
3.2의 Android와 웹에서는 사용자가 선택할 수 있는 로컬 AI 모드를 제공하지 않습니다. Android용 FFI 연동 코드는 코드베이스에 있고 libllama.so도 빌드되지만, 테스트를 마치고 지원 조건을 충족할 때만 표시되는 UI는 아직 출시하지 않았습니다. Android 하드웨어의 편차가 크고 Metal처럼 긴밀하게 통합된 환경이 없는 등 런타임 제약도 있어, 지금은 일관된 사용 경험을 약속하기 어렵습니다. 웹은 당분간 지원 대상에서 제외했습니다. 영구 저장 공간, GPU 연산 접근, 메모리 한도를 둘러싼 브라우저 제약이 계속 바뀌고 있습니다. 두 플랫폼 모두 향후 지원할 가능성은 있지만 아직 확정하지 않았습니다.
기기 내 처리와 클라우드 전송의 범위
로컬 AI를 출시한 목적은 Hedy로 회의를 처리하면서 그 회의에 관한 정보가 기기 밖으로 전혀 나가지 않도록 할 수 있게 하는 것입니다. 이를 지키려면 어떤 데이터가 어디로 가는지 구체적으로 밝혀야 합니다.
| 데이터 | Cloud AI (기본값) | 로컬 AI + 동기화 끔 |
로컬 AI + 동기화 켬 |
|---|---|---|---|
| 오디오 캡처 | 기기 내에서만 | 기기 내에서만 | 기기 내에서만 |
| 음성 텍스트 변환 | 기기 내에서만 | 기기 내에서만 | 기기 내에서만 |
| AI 분석 (요약, 메모, 채팅, 제안) |
클라우드로 전송 | 기기 내에서만 | 기기 내에서만 |
| 세션 저장 | 기기 내 + 클라우드 (암호화) |
기기 내에서만 | 기기 내 + 클라우드 (암호화) |
| 계정 정보 (이메일, 구독) |
클라우드 | 클라우드 | 클라우드 |
| 원격 측정 데이터 및 충돌 보고서 | 클라우드 (익명) |
클라우드 (익명) |
클라우드 (익명) |
대화 내용(오디오, 녹취록, AI 분석)은 AI를 클라우드 모드로 실행하거나, 사용자가 ‘클라우드 동기화’를 켜거나, 사용자가 직접 세션을 공유하는 경우에만 Hedy 서버로 전송됩니다. 클라우드 동기화를 켜면 이미 암호화된 세션 데이터를 동기화합니다. 이 기능을 로컬 추론의 대체 경로로 쓰지는 않습니다. AI 작업 자체는 설정에서 지정한 곳에서 실행됩니다.
의도적으로 구현하지 않은 것은 사용자에게 알리지 않고 클라우드로 전환하는 기능입니다. 로컬 AI를 켠 상태에서 모델이 비정상 종료되거나 생성 중 메모리가 부족해지거나 추론 오류가 발생하면, 로컬 처리 과정에서 난 오류를 호출한 쪽에 반환합니다. Hedy 서버에서 몰래 재시도하지 않습니다. 사용자가 로컬 AI를 선택한 데는 이유가 있습니다. 알리지 않고 클라우드로 넘기면 사용자가 그 기능을 켤 때 기대한 바를 저버리게 됩니다.
로컬 처리에 드는 시간
대부분의 사용자에게는 여전히 클라우드 AI가 더 낫습니다. 기술적인 내용을 보러 온 독자라면 이 대목을 홍보 문구로 포장해도 금방 알아차릴 테니 분명히 말씀드립니다.
대부분의 사용자에게 클라우드가 더 빠르며, 속도가 10배가량 차이 나는 경우도 흔합니다. 클라우드에서 몇 초 만에 끝나는 요약이 Standard 등급 로컬 모델에서는 30초 걸릴 수 있습니다. 사양이 빠듯한 기기에서 Pro 등급 모델을 고르면 몇 분이 걸릴 수도 있습니다. 회의 도중 나오는 실시간 제안도 클라우드 모드에서 반응이 눈에 띄게 빠릅니다.
반대의 결과가 나오는 경우도 있습니다. 통합 메모리 128GB를 탑재한 M5 Max 같은 최고 사양 MacBook Pro에서 성능 좋은 로컬 모델을 실행하면 클라우드보다 빠를 수 있습니다. 클라우드 추론에도 지연은 생깁니다. 호스팅 모델은 여러 사용자가 GPU 자원을 공유하므로 부하가 크거나 인기 모델의 요청이 밀리면 첫 토큰이 나오기까지 걸리는 시간이 크게 늘어날 수 있습니다. 이미 메모리에 올라간 로컬 모델에는 이런 변동이 없습니다. 매번 하드웨어가 낼 수 있는 속도로 일정하게 실행됩니다. 성능이 충분한 기기에서 짧은 요청을 처리할 때 클라우드가 바쁘다면, 실제 응답 완료까지 걸리는 시간은 로컬이 더 짧을 수 있습니다. 대부분의 사용자는 대부분의 하드웨어에서 여전히 클라우드가 평균적으로 더 빠르다고 느낄 테지만, 어느 쪽이 빠른지는 조건에 따라 달라집니다.
클라우드는 모든 플랫폼에서 작동합니다. Android, 웹, 구형 Mac이나 iPhone에서는 아직 로컬 모드를 선택할 수 없습니다.
대다수 사용자가 로컬을 선택하는 이유는 개인정보 보호입니다. 개인정보 보호를 위해 로컬을 고를 만한 수준으로 만들고자 했지만, 대부분의 하드웨어에서는 그만큼 속도를 양보해야 합니다. 회의 내용을 자기 기기에 두려는 목적이라면 로컬을 고르는 것이 합리적입니다. 속도 때문에 로컬을 고르는 건 하드웨어가 그 속도를 뒷받침할 때만 의미가 있습니다.
회의 도중 다음에 할 말을 예상하려고 LLM을 계속 실행하는 ‘자동 제안’은 부하가 큽니다. Hedy에서 연산 비용이 가장 큰 AI 작업입니다. 클라우드에서는 이 부하를 느끼지 못합니다. 로컬에서는 특히 사양이 낮은 기기에서 추론 루프가 포화돼 컴퓨터의 다른 작업까지 느려질 수 있습니다. ‘로컬 AI 처리’를 활성화하면 앱에 다음 안내 대화상자가 한 번 표시됩니다. “자동 제안은 세션 중에 AI를 계속 실행합니다. 로컬 AI 처리를 사용하면 CPU와 GPU 점유율이 높아져 컴퓨터의 다른 작업이 느려질 수 있습니다. 설정에서 언제든지 다시 켤 수 있습니다.” 로컬 모드에서는 자동 제안을 강제로 끄는 방안도 검토했습니다. 고사양 기기에서 충분히 실행할 수 있는 기능이라 사용자가 직접 결정하도록 했습니다.
주요 아키텍처 결정
기술에 관심 있는 독자라면 눈여겨볼 만한 설계 결정이 몇 가지 있습니다.
알림 없는 대체 실행 방지. 앞서 설명한 원칙입니다. 사용자가 때때로 이해하기 어려운 오류를 마주할 수 있지만, 로컬에서 처리한다는 약속은 지킬 수 있습니다.
기기별 설정. 선택한 모델과 로컬에서 실행할 기능 등 로컬 AI 설정은 기기 간에 동기화되지 않습니다. Mac에 9B 모델을 설치하고 휴대전화에 2B 모델을 설치했다면 두 기기에서 따로 설정합니다. 어떤 모델이 적합한지는 사용자의 일반적인 선호보다 현재 기기의 하드웨어에 달려 있으므로, 이 설정은 동기화에 맞지 않습니다.
파일을 삭제하기 전까지 보관 모델 선택 가능. 카탈로그의 모델에 후속 모델이 나오면(예: Qwen 3.5 27B → Qwen 3.6 27B), 이전 항목을 없애는 대신 보관 처리합니다. 이미 다운로드했다면 계속 사용할 수 있고, 기기에서 파일을 삭제하면 모델 선택 화면에서도 항목이 사라집니다. 카탈로그가 바뀌었다는 이유로 다운로드한 17GB짜리 파일을 못 쓰게 할 필요는 없습니다.
모델별 양자화 방식 선정. Unsloth는 Q2부터 Q8까지, K, K_M, K_L, XL 형식과 동적 버전을 포함해 모델마다 열두 가지에 이르는 양자화 변형을 제공합니다. 이를 전부 노출하면 잘못 고르기 쉽습니다. 대부분의 사용자가 Q4_K_M과 UD-Q4_K_XL의 차이를 알기 어렵고, 낮은 정밀도 구간에서는 품질도 급격히 떨어집니다. 저희는 모델마다 크기와 품질 사이의 균형을 보고 양자화 방식을 정합니다. 대부분 Q4_K_M을 씁니다. 27B에는 Unsloth의 동적 UD-Q4_K_XL을 씁니다. 레이어마다 다르게 양자화하면 같은 파일 크기에서도 품질을 확실히 높일 수 있습니다. RAM 여유가 있고 파라미터 등급을 그대로 유지하면서 최대한 fp16에 가까운 결과를 원하는 분을 위해 9B의 Q8_0 ‘HQ’ 버전도 제공합니다. 화면에 ‘HQ’라고 표시한 것은 의도적인 결정입니다. ‘Q8_0’을 표시하려면 모든 사용자에게 GGUF 양자화가 무엇인지 설명해야 하며, 그 부담을 지우고 싶지 않았습니다.
메모리 적합성과 속도 계산. 카탈로그의 각 항목은 모델 선택 화면에 표시되기 전에 감지된 하드웨어를 바탕으로 점수를 계산합니다. 모델별로 정해진 양자화 방식을 기준으로 필요한 메모리(가중치, KV 캐시, 작업 버퍼)를 추정하고 실제 가용 메모리와 비교합니다. GPU 메모리 대역폭을 알 수 있으면 초당 토큰 수도 추정하며, GPU에 일부만 오프로딩하거나 CPU에서만 실행하는 경우에는 그 영향을 반영해 점수를 낮춥니다. 결과는 ‘적합 ✓’, ‘간신히 적합’, ‘적합하지 않음’으로 표시하고, CPU로 넘겨 처리할 부분이 있으면 ’ + 느림’을 붙입니다. Windows에서는 모델 레이어가 VRAM에 모두 들어가지 못해 일부가 시스템 RAM으로 넘어가는 경우가 여기에 해당합니다. macOS에서는 운영체제가 다른 앱의 메모리를 회수해 가중치를 위한 메모리를 고정해야만 모델이 들어가는 경우에도 같은 표시를 붙입니다. 로드는 되지만 느려진 것을 체감할 수 있습니다. ‘권장됨’ 배지는 ‘적합 ✓‘로 분류된 모델 중 점수가 가장 높은 모델에 붙습니다. ‘간신히 적합’한 모델은 모델 자체의 품질 점수가 더 높아도 권장하지 않습니다. 한 등급 아래에서 원활히 실행되는 모델을 고르는 편이 제 속도를 내지 못하는 모델을 고르는 것보다 낫기 때문입니다.
생성 작업까지 중단하는 취소. llama.cpp의 생성 작업을 워커 아이솔레이트에서 실행해 UI 스레드가 계속 응답하도록 했습니다. 생성되는 토큰은 NativeCallable.listener를 통해 메인 아이솔레이트로 스트리밍됩니다. 취소 시에는 llama_set_abort_callback을 통해 원자적 플래그를 확인합니다. 이 동작은 추측에 맡기지 않고 업스트림 소스에서 검증했습니다. 긴 생성 작업 도중 사용자가 세션을 닫으면 작업이 실제로 멈춥니다. 백그라운드에서 작업을 끝내느라 배터리를 낭비하지 않습니다.
아직 확인하지 못한 점
아직 답을 얻지 못한 질문은 다음과 같습니다.
- 다양한 하드웨어에서 실제로 얼마나 지연되는지는 데이터가 충분하지 않습니다. 보유한 기기로 충분히 테스트하고 베타 테스터에게 의견을 물었으며 충돌 보고서도 살폈습니다. 그래도 “2018년식 내장 그래픽 Windows 노트북”처럼 드물게 쓰이는 기기까지 성능 특성을 파악하기는 어렵습니다. 출시 초기 데이터가 쌓이면 실제로 어디에서 문제가 생기는지 알 수 있을 것입니다. 자체 테스트에서는 회의 길이, 컨텍스트, 선택한 모델에 따라 로컬 추론에 걸리는 시간이 5초에서 5분까지 달랐습니다.
- 새 모델 버전을 얼마나 자주 내놓는 것이 적절한지 아직 모릅니다. 카탈로그는 이미 빠르게 바뀌고 있습니다. 한 주기 안에 Qwen이 3.5에서 3.6으로 바뀌었습니다. 지금까지는 이전 모델을 삭제하는 대신 보관 처리했지만, 전체 디스크 사용량이 감당하기 어려울 만큼 늘어나면 다른 정책이 필요할 수 있습니다.
- AI를 계속 실행하는 작업의 노트북 전력 소모는 일부 사용자의 예상보다 클 것입니다. 같은 회의라도 자동 제안을 클라우드 AI에서 실행할 때보다 로컬로 실행할 때 기기 부하가 훨씬 큽니다. 아직 배터리 상태에 따라 처리 속도를 제한하는 기능은 구현하지 않았지만, 필요할 가능성이 큽니다. 회의가 끝난 뒤 요약만 원하는 경우는 다릅니다. 생성 작업을 한 번만 실행하므로 Pro 또는 Max 등급 모델을 여유 있게 실행하는 기기라면 일반적인 배터리와 발열 한도 안에서 충분히 처리할 수 있습니다.
로컬 AI의 다음 단계
Hedy 3.2 자체보다 더 흥미로운 건 두 곡선이 계속 움직인다는 점입니다.
가중치 공개 모델은 작은 크기에서도 성능이 계속 좋아지고 있습니다. 지금의 2B급은 약 18개월 전의 7B급 수준입니다. 앞으로 12개월 동안 Gemma, Qwen, 그 밖의 주요 가중치 공개 모델 계열이 어떻게 바뀌든, 일반 노트북에서 돌릴 수 있는 모델의 성능은 계속 높아집니다.
소비자용 하드웨어의 성능도 계속 좋아지고 있습니다. Apple은 칩을 세대별로 개발하면서 추론 기능을 꾸준히 반영해 왔습니다. Windows 기기에도 NPU가 탑재되기 시작했습니다. 현재 1세대에서는 홍보에 쓰이는 경우가 대부분이지만, 결국 추론에 실질적인 역할을 할 것입니다.
이 두 흐름이 만나면서 변화가 조용히 진행 중입니다. 예전에는 AI를 쓰려면 “소수의 기업이 사용자를 대신해 대형 모델을 운영하고, 사용자는 그 기업에 데이터를 보낸다”는 방식이 당연했습니다. 이제는 “소수의 기업이 대형 모델을 학습시키지만, 사용자는 자기 데이터로 처음부터 끝까지 자기 기기에서 모델을 실행할 수 있다”는 쪽으로 바뀌고 있습니다. 현재로서는 호스팅 모델이 더 낫고 당분간은 그럴 가능성이 큽니다. 그래도 격차는 줄고 있습니다. 적지 않은 사용자에게는 “기기에서 실행할 수 있고 성능이 충분한 모델”이 “원격으로 실행되는 최고 성능 모델”보다 더 나은 선택입니다.
Hedy 3.2는 이 변화에 대한 저희의 첫 구체적인 시도입니다. 모델과 하드웨어가 발전하면 기기에서 처리하는 범위를 더 넓힐 수 있게 아키텍처를 설계했습니다. 앞으로도 이 작업을 이어갈 계획입니다.
About the author
Julian Pscheid is the founder and CEO of Hedy AI, a real-time AI meeting coach used by tens of thousands of professionals worldwide. He writes about how AI is changing the way people prepare for, capture, and understand important conversations.