完全ローカルの会議AI:Hedy 3.2で実現したことと、速度面のコスト
Hedy 3.2のオンデバイスAIに関するエンジニアリング解説。採用したモデル、Mac・Windows・iPhoneでの動作方法、ローカル推論の速度面のコストを紹介します。
Hedy 3.2では、会議の一部始終をノートパソコン上で処理し、デバイスの外には何も出さないことができます。音声、文字起こし、要約、メモ、提案まで、すべてローカルです。デフォルトは今もクラウドで、ほとんどのユーザーにとっては今もクラウドが正解です。ローカルは、会話を自分のハードウェアの中に留めておきたい方のためのもので、ある程度の速度低下を受け入れることになります(最上位クラスのハードウェアなら、そうとも限りません)。私たちは初めて、このトレードオフが誠実と言える水準に達したと考え、リリースしました。
Hedyは、Mac、Windows、iOS、Android、Webで約30,000人が使っている会議コーチです。音声認識は初日からすべてのプラットフォームでローカルに動いてきました。一方、AI分析のレイヤー(要約、詳細なメモ、セッション内チャット、「次に何を言うべきか」のライブ提案)は、これまでずっとクラウドでした。3.2で変わったのは、まさにここです。
この記事では、2026年にそれが可能になった理由、採用したモデル、そしてあえて作らなかったものを説明します。ユーザー向けの観点、つまりローカルAIが会議のワークフローにもたらすもの(プライバシー、弁護士・医療・ジャーナリストでの利用例、オンにする方法)については、会議向けローカルAIの概要をご覧ください。
2つの曲線
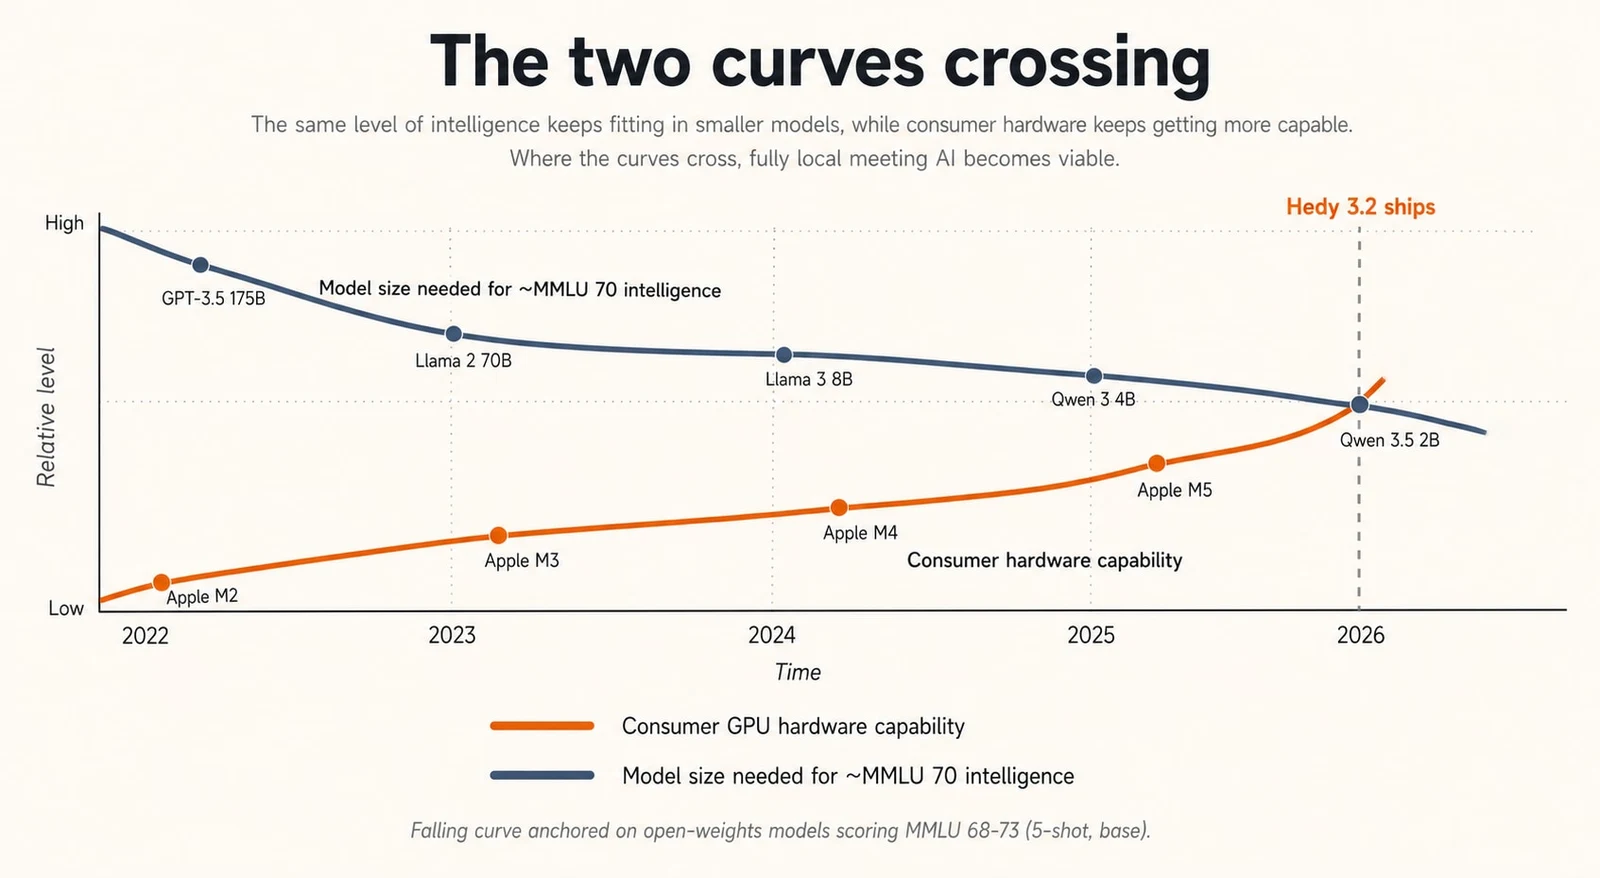
私たちは数年前から、2つのトレンドラインに注目していました。
1つ目は、オープンウェイトモデルの品質です。2023年半ばのLlama 2は、チャットボットのデモ以上の用途では物珍しい存在にすぎませんでした。2024年後半には、Llama 3とQwen 2.5が小さなサイズでも実用的になりましたが、30分の対話の中で誰が何を言ったかを追い続ける複数ターンの会議要約のようなタスクでは、まだ差を感じました。2025年から2026年初めにかけて、私たちの用途では2つのファミリーが抜きん出ました。GoogleのGemma 4と、AlibabaのQwen 3.5/3.6です。どちらのチームも、パラメータあたりの密度とでも呼ぶべきものに力を注いでおり、両者を合わせると、2Bクラスのオンデバイスモデルから35BのMoEまで幅広くカバーします。指示への追従や構造化出力で、サイズ以上の性能を発揮するモデルが複数のサイズで揃っています。
2つ目の曲線は、コンシューマー向けハードウェアです。Apple Siliconのユニファイドメモリアーキテクチャは、Transformer推論にまさに適した形でした。モデルの重みがGPUの演算ユニットのすぐそばにあり、PCIeの往復も、独立したVRAMの予算もありません。M3世代の頃には、ベースモデルの16GB MacBook Airでも、量子化した8〜9Bモデルを実用的な速度で動かせるようになりました。Windowsは別の道をたどりました。ゲーミングやコンテンツ制作向けのマシンなら、8〜12GBのVRAMを持つ単体GPUは珍しくありません。そしてVulkanベースの推論フレームワークは、NVIDIA、AMD、そして(徐々に)Intelのハードウェアから、その性能の大半を引き出せるようになっています。
この2つの曲線は2026年初めに交差しました。私たちの仕事をきちんとこなせるモデルを選べるようになり、それを動かせる消費者向けハードウェアの普及台数も十分にありました。そこで、リリースに踏み切ったのです。
何を選んだか、そしてその理由
基盤となるランタイムはllama.cppです。サブモジュールとして取り込み、プラットフォームごとに適切なバックエンドでビルドしています。重みは、UnslothのHuggingFaceビルドのGGUF量子化モデルを使っています。このサイズ帯のオープンウェイトモデルで、きちんと量子化されたものを入手できる、現時点で最もクリーンな供給元です。
リリース時点の有効なカタログは次のとおりです。
| モデル | 量子化 | ファイルサイズ | 読み込み時のRAM | 品質 |
|---|---|---|---|---|
| Qwen 3.5 2B | Q4_K_M | 1.2 GB | 3 GB | ★ |
| Qwen 3.5 4B | Q4_K_M | 2.6 GB | 4.5 GB | ★ |
| Gemma 4 E2B | Q4_K_M | 2.9 GB | 5 GB | ★ |
| Gemma 4 E4B | Q4_K_M | 4.6 GB | 7 GB | ★★ |
| Qwen 3.5 9B | Q4_K_M | 5.3 GB | 8 GB | ★★ |
| Qwen 3.5 9B HQ | Q8_0 | 8.9 GB | 12 GB | ★★ |
| Qwen 3.6 27B | UD-Q4_K_XL | 17.6 GB | 22 GB | ★★★ |
| Gemma 4 31B | Q4_K_M | 17.1 GB | 23 GB | ★★★ |
| Qwen 3.6 35B-A3B | UD-Q4_K_M | 20.6 GB | 25 GB | ★★★ |
このほか、旧バージョンのSKUがいくつかアーカイブとして残っています。すでにダウンロード済みのユーザーは引き続き選択できますが、ローカルファイルを削除するとピッカーから消えます。ピッカーは品質を3段階の星評価にまとめています。7B未満のモデルは星1つ、7〜12Bは星2つ、12B超は星3つです。量子化(Q4かQ8か)は評価に影響しません。星が示すのは生のモデル能力であり、デプロイ時の精度ではありません。
Gemma 4 E2BとGemma 4 E4Bの「E」は、Googleの「実効パラメータ」表記です。E2Bは実効約2.3B(埋め込みを含めると約5.1B)、E4Bは実効約4.5B(埋め込みを含めると約8B)です。Qwenの行は、単純な総パラメータ数で表記しています。ピッカーは、ユーザーが実際に気にする項目(読み込み時のRAMと品質の星)で並べているので、2つの表記が互いに混乱を招くことはありません。
この2つのファミリーを選んだ理由です。Gemma 4もQwen 3.5/3.6も、私たちが必要とする範囲で複数のサイズが用意されています。どちらも小さなサイズで指示への追従が強く(会議の要約は、ほとんどが「この出力スキーマに従い、幻覚を起こさない」という作業なので重要です)、どちらも商用配布が許されるライセンスで、Hedyが現在提供している51のインターフェース言語にわたってトークナイザーの挙動も安定しています。27BのQwenは、Unslothの「Unsloth Dynamic」量子化であるUD-Q4_K_XLを使っています。最も重要なレイヤーに多くの重み精度を残す方式で、同じファイルサイズの単純なQ4より、品質がはっきり向上します。
アプリ上で実際に見えるのは、お使いのマシンに対応したモデルを、ディスクサイズ、読み込み時のおおよそのRAM、星評価とともに並べたモデルピッカーです。技術的には動くものの、お使いのハードウェアで一部のレイヤーがCPUにあふれるモデルには、「+ 低速」という接尾辞が付きます。5GBをダウンロードしてから、なぜ要約に4分もかかるのかと首をかしげることになるよりは、ピッカーで正直にお伝えするほうがよいと考えています。
自分のモデルを持ち込む。 ピッカーには「カスタムモデル」セクションもあり、ディスク上の互換性のあるGGUFを指定して、厳選カタログと並べて使えます。ファイルはコピーせず、置いた場所にそのまま残ります。Hedyは永続的な参照を保持するので、アプリを再起動してもリンクは切れません。互換性の保証はありません。llama.cppが読み込めるGGUFであること、プロンプトが有用な構造化出力を返せる程度にチャットテンプレートがまともであること、そしてメモリの見積もりは自己責任です。それでも、この段落を読んで「このマシンでDeepSeek V4を試してみたい」と思う方なら、どうぞお試しください。
Apple Silicon:いちばん簡単なケース
Apple Siliconは、オンデバイスAIの未来がすでに来たように感じられるプラットフォームです。それを支えているのは3つの要素です。
1つ目は、ユニファイドメモリモデルです。GPUとCPUが同じRAMプールを共有します。量子化した8Bパラメータのモデルをメモリに読み込めば、GPUはメモリ帯域幅の速度で重みを読み出せます。WindowsのディスクリートGPU構成では当たり前のVRAMへのコピーのオーバーヘッドがありません。トークンごとに何千回も重みを演算に流し込む推論では、これは構造的に大きな利点です。
2つ目は、Metalです。AppleのGPU演算APIは成熟していてドキュメントも充実しており、llama.cppのMetalバックエンドは最も洗練されたものの1つです。ビルドはGGML_METAL=ONで行い、その上に特別なことは何もしていません。
3つ目は、Mシリーズチップの最低ラインです。ベースモデルのM1でも、小さな量子化モデルを対話的な速度で動かすのに十分なGPU性能とメモリ帯域幅があります。
実際のところ、カタログとの対応は次のようになります。
| モデル | 品質 | 読み込み時のRAM | 8 GB | 16 GB | 24 GB | 32 GB | 64 GB+ |
|---|---|---|---|---|---|---|---|
| Qwen 3.5 2B | ★ | 3 GB | ● | ● | ● | ● | ● |
| Qwen 3.5 4B | ★ | 4.5 GB | ● | ● | ● | ● | ● |
| Gemma 4 E2B | ★ | 5 GB | ◐ | ● | ● | ● | ● |
| Gemma 4 E4B | ★★ | 7 GB | — | ● | ● | ● | ● |
| Qwen 3.5 9B | ★★ | 8 GB | — | ● | ● | ● | ● |
| Qwen 3.5 9B HQ | ★★ | 12 GB | — | ◐ | ● | ● | ● |
| Qwen 3.6 27B | ★★★ | 22 GB | — | — | ◐ | ● | ● |
| Gemma 4 31B | ★★★ | 23 GB | — | — | ◐ | ● | ● |
| Qwen 3.6 35B-A3B | ★★★ | 25 GB | — | — | — | ◐ | ● |
● 余裕で動作 · ◐ ぎりぎり(読み込めるが、長い会議ではOSに負荷がかかる。ピッカーには「+ 低速」と表示) · — 読み込めない
この表では伝えきれない点がいくつかあります。星1つのモデルは、構造化出力と短い要約が得意ですが、複数の話者が登場する長い会議は苦手です。星2つの帯(Gemma 4 E4BとQwen 3.5 9B)は、ベースモデルのMacBook Airを含め、ほとんどのユーザーにとってちょうどよい水準です。私たちのタスクでは、ホスト型の小型フロンティアモデルに近づいています。Qwen 3.5 9B HQは、パラメータ数は同じでQ4ではなくQ8にしたものです。パラメータのクラスを1つ上げるほどの品質向上ではありませんが、余裕があれば実感できる差です。35B-A3BはMoEです。総パラメータは35Bですが、トークンごとに有効になるのは約3Bだけなので、推論速度ではサイズ以上の性能を発揮します。
いちばん嬉しい驚きは、ベースモデルのMacBook Airで星2つの帯がどれほどうまく動くかでした。私たちは、ローカルAIはパワーユーザー向けだとお伝えする覚悟をしていました。Apple Siliconでは、そうではありませんでした。
Windows:VRAMとあふれの問題
Windowsはもっと複雑です。ハードウェアのばらつきが非常に大きいのです。最近のゲーミングデスクトップに4080を載せた開発者は、私たちが対応するどのMacよりも高い推論性能を持っています。一方で、内蔵グラフィックスのビジネス用ノートパソコンを使うナレッジワーカーには、事実上ほとんどありません。
Windows版では、方針をはっきりさせました。ローカルAIにはVulkanが必須です。WindowsのCMakeビルドは、ビルド時にVulkan SDKがあればGGML_VULKAN=ONを設定し、なければllama.dllターゲット自体をスキップします。Windowsでは、ローカルAIにCPUのみのフォールバックはありません。CUDAならNVIDIAでより高速ですが、体験を単一のGPUベンダーに縛れば、AMDとIntelのユーザーを全員切り捨てることになります。VulkanならNVIDIAでCUDAに迫る性能が得られ、私たちのユーザーが実際に使っているGPUベンダーすべてで動く唯一の道です。
Windowsでの問題の形は、Macとは異なります。ディスクリートGPUにはシステムRAMとは別の専用VRAMがあり、GPUによる完全な高速化を得るには、モデルがそのVRAMに収まる必要があります。モデルがわずかに大きすぎる場合、llama.cppはモデルを分割できます。大半のレイヤーをGPUに置き、残りをCPUで実行するのです。動きはしますが、トークンはそのたびに、連鎖の中でいちばん遅いレイヤーを待つことになります。「VRAMに収まる」状態から「2レイヤーがCPU」の状態に移っただけで、スループットがおよそ半分になったケースを確認しています。数レイヤーを超えてあふれるようなら、最初からCPUで動かしているのと変わりません。
分割を正しく計算することが重要です。カタログの各モデルにはnumLayersが記録されています(Qwen 2Bは24、Qwen 4Bは32など、各モデルのHuggingFace config.jsonから取得)。非現実的に大きな値をllama.cppのn_gpu_layersに渡しても何も得られません。llama.cppはオフロードをモデルの実際のレイヤー数で打ち切り、水増しした値に対する適合予測やあふれの計算は、黙って誤った答えを返します。そのため、カタログの数値は正確に保っています。
モデルピッカーでは、結果を具体的にお伝えする方針です。利用可能なVRAMを確認し、モデルのフットプリント(重みにKVキャッシュと作業用バッファを加えたもの)を計算して、次のように扱います。
- モデルが収まる場合は、通常どおり一覧に表示します。
- CPUへのあふれが穏やかな場合は「+ 低速」の接尾辞を付け、ユーザーが目立つ遅延を見込めるようにします。
- 壊滅的にあふれる場合は、そのハードウェアでは一覧にまったく表示しません。
GPUが検出されない、または最小のモデルにすら十分なメモリがない場合、設定のローカルAIセクションには、ピッカーの代わりにブロックの理由が表示されます。
Windowsに固有の細かな点を1つ挙げておきます。NVIDIAのドライバーバージョン595.xxには、特定のWindowsビルドのRTX 40シリーズカードでVulkan演算に既知の問題があり、モデル読み込み中にFAST_FAILクラッシュが起きていました。私たちは自分たちがバグを出荷したと考えて調査しましたが、同じドライバーバージョンで無関係のVulkanアプリケーションにも同じクラッシュのシグネチャが出ていることに気づきました。修正は上流で行われ、NVIDIAの596.21ドライバーに入りました。現在はより分かりやすいエラーメッセージを表示していますが、実際の解決策は「ドライバーを更新する」ことです。
モバイル:最小のティア、差についても正直に
ローカルAIを有効にしたのは、iPhone 15 Pro以降(A17 Proチップ以上)と、MシリーズまたはA17 Proチップ搭載のiPadだけです。理由は単純で、それより古い端末は、最小のティアでさえ許容できる速度で動かせるだけのユニファイドメモリもNeural Engineの世代も備えていないからです。
15 Proであっても、動かすのはコンパクトティアのモデルです。Qwen 3.5 2B、Qwen 3.5 4B、Gemma 4 E2Bがそれにあたります。2〜5Bパラメータの量子化モデルは、9Bとは別の種類の書き手です。構造化出力が得意で、明確な指示にもよく従い、短い要約もそれなりにこなします。長い会議、とくに話者が多い会議や専門用語の多い会議では、筋を見失います。モバイルUIではこの点を率直に示しており、ローカルモデルであることを明示したうえで、スマートフォンでの本格的な会議分析にはクラウドAIをデフォルトにすることをお勧めしています。
AndroidとWebには、3.2時点ではユーザー向けのローカルAIモードがありません。AndroidのFFIの仕組みはコードベースに存在します(libllama.soもビルドされています)が、テスト済みでゲート制御されたUIはまだリリースしていません。Androidのハードウェアのばらつきと、ランタイム面の制約(Metalのような密接な統合に相当するものがない)のために、現時点で一貫した体験を約束するのは困難です。Webは今のところ対象外です。永続ストレージ、GPU演算へのアクセス、メモリ上限に関するブラウザの制約は、いまだ流動的です。どちらも、おそらくは今後対応します。ただし、どちらも確約はしていません。
ローカルに留まるもの、留まらないもの
ローカルAIをリリースする狙いは、Hedyで会議を行っても、その会議に関するものが何ひとつマシンの外に出ないようにできることです。私たちはこの目標を真剣に受け止めており、それは、何がどこを流れるのかを正確に示すことを意味します。
| データ | クラウドAI(デフォルト) | ローカルAI +同期オフ |
ローカルAI +同期オン |
|---|---|---|---|
| 音声の取り込み | ローカルのみ | ローカルのみ | ローカルのみ |
| 文字起こし | ローカルのみ | ローカルのみ | ローカルのみ |
| AI分析 (要約、メモ、チャット、提案) |
クラウドへ送信 | ローカルのみ | ローカルのみ |
| セッションの保存 | ローカル+クラウド (暗号化) |
ローカルのみ | ローカル+クラウド (暗号化) |
| アカウント情報 (メールアドレス、サブスクリプション) |
クラウド | クラウド | クラウド |
| テレメトリとクラッシュレポート | クラウド (匿名) |
クラウド (匿名) |
クラウド (匿名) |
会話の内容(音声、文字起こし、AI分析)が私たちのサーバーに届くのは、AI処理がクラウドモードのとき、ユーザーがクラウド同期を有効にしたとき、またはユーザーが明示的にセッションを共有したときだけです。クラウド同期は、有効にした場合でも、すでに暗号化されたセッションデータの上に載る同期レイヤーにすぎず、推論のフォールバック経路になることはありません。AI処理そのものは、設定した場所で動き続けます。
私たちがあえて作らなかったのは、黙ってクラウドにフォールバックする仕組みです。ローカルAIをオンにしている状態でローカルのパイプラインが失敗した場合(モデルのクラッシュ、生成途中のメモリ不足、推論エラーなど)、エラーは呼び出し元に表示されます。私たちのサーバーに対する、こっそりとした再試行はありません。ローカルAIをオンにした人には、そうする理由があります。知らせずにクラウドへフォールバックすれば、オプトインしたときの前提を裏切ることになります。
コストはどれほどか
ほとんどのユーザーにとって、クラウドAIは今もより優れています。この記事を読む技術系の読者は、この点についてどんな宣伝文句も見抜くでしょうから、はっきり言っておく必要があります。
ほとんどのユーザーにとって、クラウドのほうが速く、しばしば桁違いです。私たちのクラウドパイプラインなら数秒で終わる要約が、ローカルのスタンダードティアのモデルでは30秒かかることがあり、ボーダーラインのマシンでProティアのモデルを選んだ場合は数分かかることもあります。会議の進行中に発火するライブ提案は、クラウドモードのほうが目に見えて反応が良好です。
ここで触れておくべき、正直な例外があります。最上位スペックのMacBook Pro(たとえば128GBのユニファイドメモリを搭載したM5 Max)で強力なローカルモデルを動かすと、比較が逆転することがあります。クラウド推論にも、独自のレイテンシの問題がないわけではありません。ホスト型のモデルは多くのユーザーでGPUの容量を共有するため、負荷が高いときや人気のモデルが滞留しているときには、最初のトークンまでの時間が大きく膨らむことがあります。すでにメモリに読み込まれたローカルモデルには、そうしたばらつきがありません。お使いのハードウェアが出せる速度で、毎回、決定論的に動作します。十分な性能のハードウェアで、クラウドが混雑している間に短いクエリを実行するユーザーにとっては、ローカルが実時間で実際に勝つこともあります。過大に主張するつもりはありませんが(ほとんどのハードウェアのほとんどのユーザーは、平均的にはクラウドのほうが速いと感じるでしょう)、あえて口に出しておく価値があります。速度の比較は一方通行ではありません。
クラウドはすべてのプラットフォームで動きます。ローカルはそうではありません。AndroidやWeb、または古いMacやiPhoneをお使いの場合、ローカルモードはまだ選択肢になりません。
多くのユーザーがローカルを選ぶ理由は、性能ではなくプライバシーでしょう。私たちは、プライバシーのトレードオフが単なる身振りではなく実質を伴うものになるよう、ローカルを十分に使えるものにする努力をしてきましたが、ほとんどのハードウェアでは、それは今もトレードオフです。会議を自分のマシンの中に置いておきたいからローカルを選ぶのは、理にかなっています。速度だけを理由に選ぶのは、お使いのハードウェアがそれを裏付けられる場合に限られます。
特に注意していただきたい点があります。自動提案は、会議中に次に何を言うかを先回りするため、LLMを継続的に動かす機能で、重い処理です。Hedyが行うAIワークロードの中で最もコストが高いものです。クラウドでは気になりません。ローカルでは、とくに小さなマシンでは、推論ループを飽和させ、コンピューターの残りの動作を遅くすることがあります。アプリには、ローカルAI処理を有効にしたときに1回だけ表示されるガイダンスのダイアログがあります。「自動提案は、セッション中にAIを継続的に実行します。ローカルAI処理を使用すると、CPUとGPUの負荷が高まり、コンピュータの他の動作が遅くなる可能性があります。設定からいつでも再度オンにすることができます。」ローカルモードで自動提案を強制的に無効にすることも検討しましたが、見送りました。ハイエンドのマシンをお持ちの方なら動かせますし、押しつけがましいことはしたくないからです。
語っておく価値のあるアーキテクチャ上の判断
技術的な読者の方に面白いと感じていただけそうな、意図的に行ったことをいくつか紹介します。
黙ったフォールバックはしない。 すでに述べたとおりです。ユーザーが負担するのは、ときどき混乱を招くエラーです。得られるのは、言ったとおりに動く機能です。
デバイスごとの設定。 ローカルAIの設定(どのモデルを選んだか、どの機能がローカルを使うか)は、デバイス間で同期しません。Macには9Bモデルが入っていて、スマートフォンには2Bモデルが入っている、というように、別々に設定されます。ここで同期するのは間違いでしょう。適切なモデルは、ユーザーが抽象的に何を好むかではなく、どのハードウェアを使っているかで決まるからです。
アーカイブしたモデルは、削除するまで選択可能なまま。 カタログのモデルが新しいものに置き換わったとき(たとえばQwen 3.5 27BからQwen 3.6 27Bへ)、古いエントリは削除せずアーカイブとしてマークします。すでにダウンロードしたユーザーはそのまま使い続けられ、ローカルファイルを削除するとエントリはUIから完全に消えます。カタログが先へ進んだからといって、17GBのダウンロードを使えなくするようなことは、私たちのやり方ではありません。
量子化は、調整つまみではなく、厳選した選択として。 Unslothは各モデルを、十数種類の量子化バリエーションで配布しています。Q2からQ8まで、K、K_M、K_L、XLの種類があり、ダイナミック版もあります。そのすべてを公開すれば、自分の足を撃つ道具になります。ほとんどのユーザーは、Q4_K_MとUD-Q4_K_XLの違いを見分けられませんし、低い側では品質の崖が急です。私たちはモデルごとに、そのモデルにおけるサイズと品質のトレードオフに基づいて、特定の量子化を選んでいます。ほとんどはQ4_K_Mです。27Bには、レイヤーを考慮した量子化で同じファイルサイズのまま実質的な品質を取り戻せる、UnslothのダイナミックなUD-Q4_K_XLを使っています。9BにはQ8_0の「HQ」版を用意しました。RAMに余裕があり、そのパラメータクラスで利用できるfp16に最も近い体験を望むユーザー向けです。「HQ」というラベルは意図したものです。UI上で「Q8_0」と表示すれば、すべてのユーザーにGGUF量子化とは何かを教えることになり、それは私たちが課したい負担ではありません。
適合度と速度は、推測ではなく計算する。 カタログの各エントリは、ピッカーに表示される前に、検出されたハードウェアに対するスコアリングアルゴリズムを通ります。スコアラーは、必要なメモリ(モデルのカタログ上の量子化での重み、KVキャッシュ、作業用バッファ)を実際に利用可能な量と比較して見積もり、GPUのメモリ帯域幅が分かっていればそれを使って毎秒のトークン数を見積もります(部分的なGPUオフロードとCPUのみの実行にはモードごとのペナルティを適用)。そこから、適合度の分類(「最適なフィット」/「ぎりぎりのフィット」/「適合しません」)と、実行にCPUオフロードが伴う場合の「+ 低速」の接尾辞を導きます。Windowsではそれが典型的なケースです。モデルのレイヤーがVRAMからシステムRAMにあふれます。macOSでは、重みのためのメモリを固定(ワイヤード)するために、OSに他のアプリを追い出させるほどの負荷をかけて、ようやく収まる場合に同じ接尾辞が付きます。技術的には読み込めますが、体感できる遅さになります。「推奨」バッジは、「最適なフィット」に収まる(「ぎりぎりのフィット」ではない)モデルのうち、最高スコアのものに付きます。素の品質ではより高いスコアになるとしても、「ぎりぎりのフィット」のモデルは意図的に推奨しません。本来より目に見えて遅く動くモデルに誘導するよりも、1段階下の、きちんと動くモデルに誘導するほうがましだからです。
きちんと働くキャンセル。 llama.cppの生成はワーカーアイソレートで実行されるため、UIスレッドは応答性を保てます。トークンはNativeCallable.listenerでメインのアイソレートにストリーミングされます。キャンセルは、アトミックなフラグを確認するllama_set_abort_callbackを通じて行います。推測ではなく、上流のソースで検証済みです。そのため、ユーザーが長い生成の途中でセッションを閉じると、処理は本当に止まります。バックグラウンドで最後まで走ってバッテリーを無駄にすることはありません。
まだ分かっていないこと
正直なリストです。
- 幅広いハードウェアでの実環境のレイテンシについて、十分な数値はまだありません。私たちは手元のマシンで徹底的にテストし、ベータテスターに調査を行い、クラッシュレポートを読みましたが、「2018年製の内蔵グラフィックスのWindowsノートパソコン」のようなロングテールは、特徴づけるのが困難です。初期の本番データが、実際にどこにでこぼこがあるかを教えてくれるでしょう。私たち自身のテストでは、会議の長さ、コンテキスト、選んだモデルによって、ローカル推論は5秒から5分まで幅がありました。
- 新しいモデルバージョンを出す適切な頻度は分かっていません。カタログの入れ替わりはすでに現実のものです(Qwen 3.5から3.6へ、1サイクルで)。これまでは削除ではなくアーカイブで対処してきましたが、全体のディスク使用量が手に負えなくなれば、別の方針が必要になるかもしれません。
- ノートパソコンの消費電力は、継続的にAIを動かすワークロードで、一部のユーザーを驚かせるでしょう。自動提案をローカルで動かした会議は、同じ会議をクラウドAIで行う場合よりもはるかに負荷が高くなります。バッテリーを考慮したスロットリングはまだ作っておらず、おそらく作るべきでしょう。会議の終わりに要約だけが欲しい場合は話が別です。それは1回だけの生成で、ProティアまたはMaxティアのモデルを楽に動かせるマシンなら、一般的なバッテリーと熱の余裕の範囲に十分収まります。
この先に向かうところ
興味深い話は、Hedy 3.2そのものではありません。曲線が動き続けていることです。
オープンウェイトモデルは、小さなサイズでも良くなり続けています。今日の2Bクラスは、18か月前の7Bクラスとほぼ同じ水準です。今後12か月のGemma、Qwen、その他の本格的なオープンウェイトのファミリーがどうなるにせよ、「普通のノートパソコンで動くもの」の下限は上がり続けます。
コンシューマー向けハードウェアも、能力を高め続けています。Appleのチップ世代は、推論をシリコンのロードマップに静かに組み込んできました。WindowsはNPUの搭載を始めており、いずれ推論で重要になるでしょう。現時点の第1世代は、ほとんどがマーケティング上の話にとどまりますが。
その組み合わせは、静かな変化が進行していることを意味します。AIはかつて、「一握りの企業が大規模なモデルを運営し、あなたの代わりに動かし、あなたはそこへデータを送る」ことを意味していました。それが、「一握りの企業が大規模なモデルを訓練するが、あなたは自分のデバイスで、自分のデータを使って、端から端まで動かせる」ものへと変わりつつあります。ホスト型のほうが今日はまだ優れており、おそらくしばらくはそうでしょう。しかし差は縮まっており、一定数のユーザーにとっては、「十分に良くてローカル」が「最高だがリモート」に勝ちます。
Hedy 3.2は、その変化への私たちの最初の具体的な賭けです。アーキテクチャは、モデルとハードウェアが許すにつれて、さらにレバーを引けるように作ってあります。続きがあります。
About the author
Julian Pscheid is the founder and CEO of Hedy AI, a real-time AI meeting coach used by tens of thousands of professionals worldwide. He writes about how AI is changing the way people prepare for, capture, and understand important conversations.



