Полностью локальный ИИ для встреч: что вышло в Hedy 3.2 и чем он обходится в скорости
Технический разбор локального ИИ в Hedy 3.2: какие модели мы выбрали, как они помещаются на Mac, Windows и iPhone и чем локальный вывод обходится в скорости.
Hedy 3.2 может пропустить целую встречу через ваш ноутбук, и ничего не покинет устройство: аудио, транскрипция, резюме, заметки, подсказки, всё локально. Облако по-прежнему наш вариант по умолчанию, и для большинства пользователей оно по-прежнему лучший выбор. Локальный режим для тех, кто предпочитает держать свои разговоры на собственном оборудовании, даже если ради этого придётся смириться с потерей скорости (а на топовом железе иногда и без неё). Впервые мы считаем, что такой компромисс достаточно честен, чтобы его выпускать.
Hedy — коуч для встреч, которым пользуются около 30 000 человек на Mac, Windows, iOS, Android и в вебе. Распознавание речи работает локально на каждой платформе с первого дня. Слой ИИ-анализа (резюме, подробные заметки, чат во время сессии, подсказки «что сказать дальше» в реальном времени) всегда был облачным. Именно это изменилось в версии 3.2.
Эта статья о том, что сделало это возможным в 2026 году, какие модели мы выбрали и что мы сознательно не стали создавать. О том, что локальный ИИ значит для вашей работы со встречами (конфиденциальность, сценарии для юристов, врачей и журналистов, как его включить), читайте в нашем обзоре локального ИИ для встреч.
Две кривые
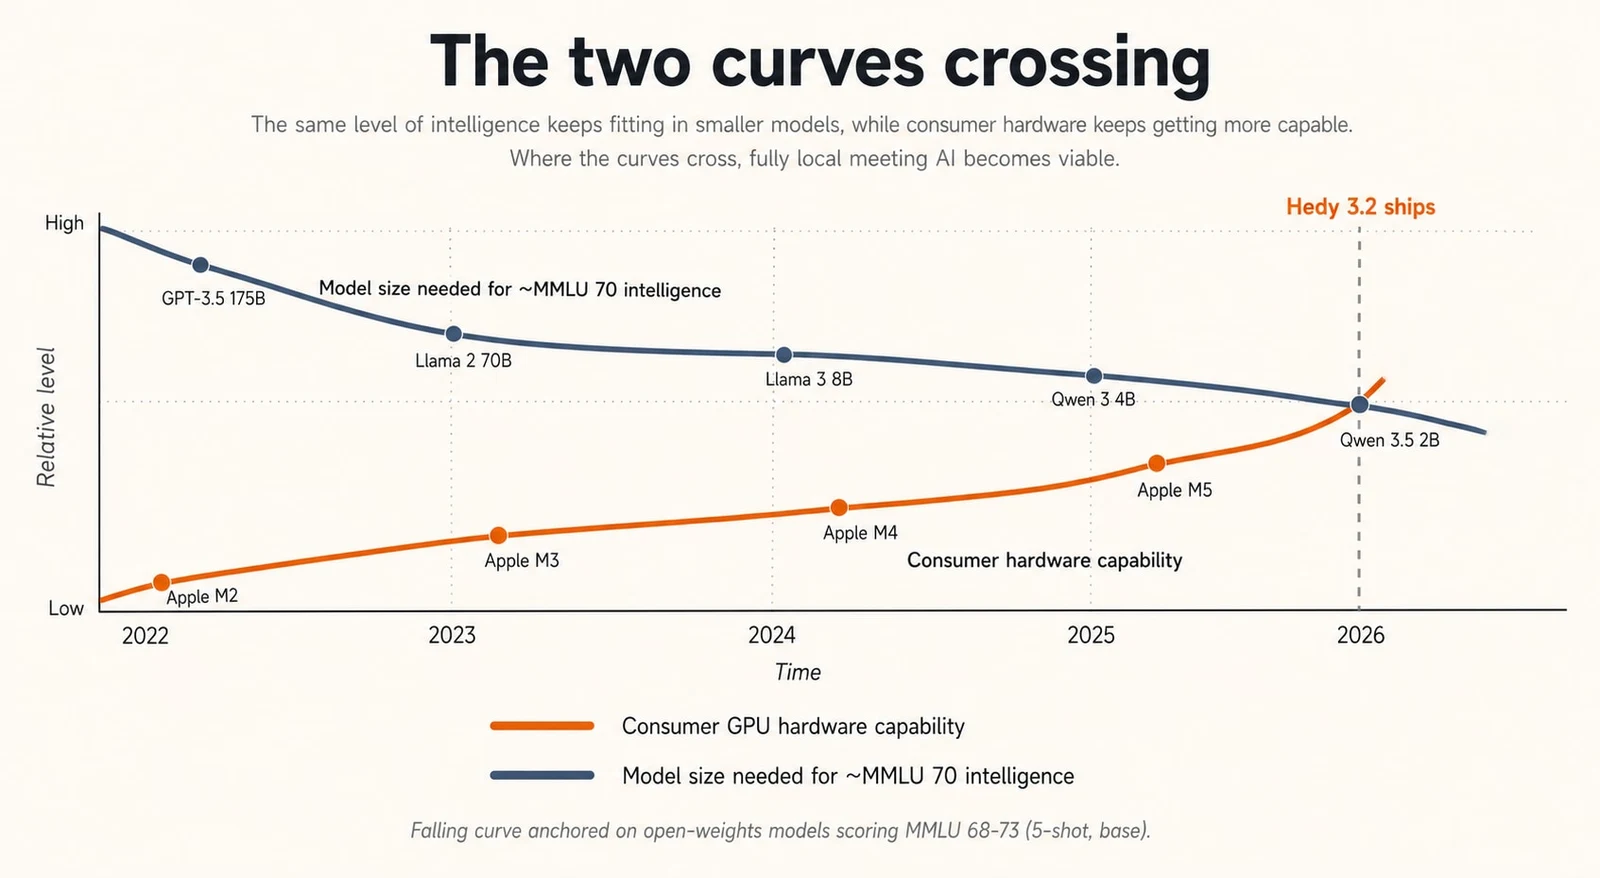
Пару лет мы следили за двумя трендами.
Первая — качество моделей с открытыми весами. Llama 2 в середине 2023 года была диковинкой для всего, что не демо-чатбот. К концу 2024 года Llama 3 и Qwen 2.5 стали действительно полезны на малых размерах, но разрыв всё ещё ощущался в задачах вроде многоходового резюмирования встреч, где модель должна отслеживать, кто что сказал на протяжении тридцати минут диалога. В течение 2025 года и в начале 2026-го для нашей задачи вперёд вырвались два семейства: Gemma 4 от Google и Qwen 3.5/3.6 от Alibaba. Обе команды вложили серьёзные усилия в то, что можно назвать плотностью на параметр, и вместе они покрывают всё от моделей класса 2B для устройств до 35B MoE, причём несколько размеров показывают в следовании инструкциям и структурированном выводе результаты выше своей весовой категории.
Вторая кривая — потребительское оборудование. Архитектура унифицированной памяти Apple Silicon оказалась ровно той формы, что нужна для вывода трансформеров: веса модели лежат рядом с вычислениями GPU, без обмена по PCIe и отдельного бюджета видеопамяти. К поколению M3 базовый MacBook Air с 16 ГБ мог запускать квантованную модель на 8–9B с приемлемой скоростью. Windows пошла другим путём. Дискретные GPU с 8–12 ГБ видеопамяти есть в любой машине, продаваемой для игр или создания контента, а фреймворки вывода на Vulkan теперь выжимают из оборудования NVIDIA, AMD и (всё чаще) Intel большую часть производительности.
Две кривые пересеклись в начале 2026 года. Мы могли выбрать модель, которая хорошо делала нашу работу, и существовала установленная база потребительского оборудования, способного её запустить. Поэтому мы и выпустили эту функцию.
Что мы выбрали и почему
В основе лежит llama.cpp, подключённый как подмодуль и собираемый под каждую платформу с подходящим бэкендом. Мы используем квантованные веса GGUF из сборок Unsloth на HuggingFace, которые сейчас остаются самым чистым источником хорошо квантованных моделей с открытыми весами в этом диапазоне размеров.
Активный каталог на момент выпуска:
| Модель | Квантование | Размер файла | ОЗУ при загрузке | Качество |
|---|---|---|---|---|
| Qwen 3.5 2B | Q4_K_M | 1.2 GB | 3 GB | ★ |
| Qwen 3.5 4B | Q4_K_M | 2.6 GB | 4.5 GB | ★ |
| Gemma 4 E2B | Q4_K_M | 2.9 GB | 5 GB | ★ |
| Gemma 4 E4B | Q4_K_M | 4.6 GB | 7 GB | ★★ |
| Qwen 3.5 9B | Q4_K_M | 5.3 GB | 8 GB | ★★ |
| Qwen 3.5 9B HQ | Q8_0 | 8.9 GB | 12 GB | ★★ |
| Qwen 3.6 27B | UD-Q4_K_XL | 17.6 GB | 22 GB | ★★★ |
| Gemma 4 31B | Q4_K_M | 17.1 GB | 23 GB | ★★★ |
| Qwen 3.6 35B-A3B | UD-Q4_K_M | 20.6 GB | 25 GB | ★★★ |
Плюс несколько архивных версий прежних моделей, которые остаются доступными для выбора у тех, кто их уже скачал, но исчезают из списка после удаления локального файла. Выбор моделей сводит всё в трёхзвёздочную оценку качества: одна звезда для моделей меньше 7B, две для 7–12B, три для больше 12B. Квантование (Q4 или Q8) оценку не меняет: звёзды говорят об исходных возможностях, а не о точности развёртывания.
Префикс «E» у Gemma 4 E2B и E4B — это обозначение «эффективных параметров» от Google: E2B — это примерно 2,3B эффективных параметров и около 5,1B с учётом эмбеддингов, а E4B — примерно 4,5B эффективных и около 8B с эмбеддингами. В строках Qwen указано просто общее число параметров. Мы сортируем список по тому, что действительно важно пользователям (ОЗУ при загрузке и звёзды качества), и это не даёт двум системам обозначений путаться друг с другом.
Почему именно эти два семейства. И Gemma 4, и Qwen 3.5/3.6 выходят в нескольких размерах в нужном нам диапазоне, обе сильны в следовании инструкциям на малых размерах (а это важно, потому что резюмирование встреч — это по большей части «следуй этой схеме вывода и не выдумывай»), обе имеют лицензию, допускающую коммерческое распространение, и обе имеют хорошо работающие токенизаторы для 51 языка интерфейса, на которых сейчас выходит Hedy. Вариант Qwen 27B использует квантование UD-Q4_K_XL от Unsloth («Unsloth Dynamic»), которое сохраняет больше точности весов в самых важных слоях. Это заметный шаг вперёд по сравнению с обычным Q4 при том же размере файла.
В приложении вы видите список моделей, совместимых с вашим компьютером, с размером на диске, приблизительным объёмом ОЗУ при загрузке и оценкой в звёздах. Если модель технически запустится, но часть слоёв уйдёт на CPU вашего оборудования, к записи добавляется суффикс «+ Медленно». Лучше честно предупредить в списке, чем заставить кого-то скачать 5 ГБ, а потом гадать, почему резюме готовится четыре минуты.
Своя модель. В списке есть и раздел «Пользовательские модели», где можно указать Hedy любой совместимый GGUF на диске и использовать его наряду с подобранным каталогом. Мы не копируем файл: он остаётся там, где вы его положили, а Hedy хранит постоянную ссылку, чтобы связь сохранялась между запусками. Гарантий совместимости нет: это должен быть GGUF, который llama.cpp может загрузить, шаблон чата должен быть достаточно вменяемым, чтобы наши подсказки возвращали полезный структурированный вывод, а бюджет памяти на вас. Но если вы из тех, кто читает этот абзац и думает «а я попробую DeepSeek V4», пожалуйста.
Apple Silicon: простой случай
Apple Silicon — платформа, на которой ИИ на устройстве ощущается так, будто будущее уже наступило. За этим стоят три вещи.
Во-первых, модель унифицированной памяти. GPU и CPU делят один пул ОЗУ. Загрузка квантованной модели на 8B параметров в память означает, что GPU читает эти веса на скорости памяти, без накладных расходов на копирование в видеопамять, как это принято в конфигурациях Windows с дискретным GPU. Для вывода, где вы прогоняете веса через вычисления тысячи раз на токен, это существенное структурное преимущество.
Во-вторых, Metal. API вычислений на GPU от Apple зрелый, хорошо документирован, а бэкенд Metal в llama.cpp — один из самых отточенных. Мы компилируем с GGML_METAL=ON и ничего экзотического поверх него не делаем.
В-третьих, нижняя планка чипов M-серии. Даже базового M1 хватает по мощности GPU и пропускной способности памяти, чтобы запускать небольшие квантованные модели с интерактивной скоростью.
На практике это сопоставляется с каталогом так:
| Модель | Качество | ОЗУ при загрузке | 8 GB | 16 GB | 24 GB | 32 GB | 64 GB+ |
|---|---|---|---|---|---|---|---|
| Qwen 3.5 2B | ★ | 3 GB | ● | ● | ● | ● | ● |
| Qwen 3.5 4B | ★ | 4.5 GB | ● | ● | ● | ● | ● |
| Gemma 4 E2B | ★ | 5 GB | ◐ | ● | ● | ● | ● |
| Gemma 4 E4B | ★★ | 7 GB | — | ● | ● | ● | ● |
| Qwen 3.5 9B | ★★ | 8 GB | — | ● | ● | ● | ● |
| Qwen 3.5 9B HQ | ★★ | 12 GB | — | ◐ | ● | ● | ● |
| Qwen 3.6 27B | ★★★ | 22 GB | — | — | ◐ | ● | ● |
| Gemma 4 31B | ★★★ | 23 GB | — | — | ◐ | ● | ● |
| Qwen 3.6 35B-A3B | ★★★ | 25 GB | — | — | — | ◐ | ● |
● подходит с запасом · ◐ впритык (загружается, но нагружает ОС во время долгой встречи; в списке показано «+ Медленно») · — не загрузится
Несколько замечаний о том, чего матрица показать не может. Однозвёздочные модели хороши в структурированном выводе и коротких резюме, слабее на длинных встречах со многими говорящими. Двухзвёздочный диапазон — Gemma 4 E4B и Qwen 3.5 9B — золотая середина для большинства пользователей, включая MacBook Air базовой комплектации; на нашей задаче он приближается к размещённой в облаке небольшой передовой модели. Qwen 3.5 9B HQ — то же число параметров в Q8 вместо Q4: скачок качества меньше, чем при переходе в следующий класс параметров, но реальный, если есть запас памяти. 35B-A3B — это MoE: 35B параметров всего, но только около 3B активны на токен, поэтому по скорости вывода она выступает выше своей весовой категории.
Самым приятным сюрпризом стало то, как хорошо двухзвёздочный диапазон ведёт себя на MacBook Air базовой комплектации. Мы были готовы сказать пользователям, что локальный ИИ — для продвинутых. На Apple Silicon это не так.
Windows: видеопамять и проблема переполнения
С Windows сложнее. Разброс оборудования огромен: у разработчика с недавним игровым десктопом и 4080 больше вычислительной мощности для вывода, чем у любого Mac, который мы поддерживаем, а у офисного сотрудника на бизнес-ноутбуке с интегрированной графикой её практически нет.
Мы заняли жёсткую позицию в сборке для Windows: для локального ИИ требуется Vulkan. Сборка CMake для Windows включает GGML_VULKAN=ON, если Vulkan SDK присутствует во время сборки, и полностью пропускает цель llama.dll, если его нет. Режима только на CPU для локального ИИ на Windows нет. CUDA была бы быстрее на NVIDIA, но привязка к одному производителю GPU означала бы отказ от всех пользователей AMD и Intel. Vulkan даёт результат, близкий к CUDA на NVIDIA, и это единственный путь, работающий у производителей GPU, которыми реально владеет наша аудитория.
На Windows проблема устроена иначе, чем на Mac. У дискретных GPU собственная видеопамять, отдельная от системной ОЗУ, и модель должна в неё поместиться, чтобы получить полное ускорение GPU. Если модель немного велика, llama.cpp может её разделить: большинство слоёв идёт на GPU, остальные работают на CPU. Это работает, но теперь каждый токен ждёт самый медленный слой в цепочке. Мы видели случаи, когда переход от «помещается в видеопамять» к «два слоя на CPU» сокращал пропускную способность примерно вдвое. Когда вы переливаете больше пары слоёв, можно с тем же успехом работать на CPU.
Правильный расчёт разделения важен. Для каждой модели в каталоге записано numLayers (24 для Qwen 2B, 32 для Qwen 4B и так далее, значения берутся из config.json модели на HuggingFace). Передача нереалистично большого значения в n_gpu_layers llama.cpp ничего не даёт: llama.cpp ограничивает выгрузку реальным числом слоёв модели, а любой прогноз помещаемости или расчёт переполнения по завышенному значению молча даёт неверный ответ. Поэтому мы держим эти числа в каталоге честными.
В списке моделей мы стараемся быть конкретными по результату. Мы проверяем доступную видеопамять, рассчитываем объём модели (веса плюс KV-кэш плюс рабочий буфер) и:
- Если модель помещается, мы показываем её как обычно.
- Если она умеренно переполняется на CPU, мы добавляем суффикс «+ Медленно», чтобы пользователи ждали заметной задержки.
- Если переполнение было бы катастрофическим, мы вообще не показываем её на этом оборудовании.
Если GPU не обнаружен или памяти не хватает даже для самой маленькой модели, раздел локального ИИ в настройках показывает причину блокировки вместо списка.
Одна специфическая деталь Windows, о которой стоит упомянуть: у драйвера NVIDIA версии 595.xx была известная проблема с вычислениями Vulkan на картах RTX 40-й серии в некоторых сборках Windows, вызывавшая сбои FAST_FAIL при загрузке модели. Мы расследовали это, думая, что выпустили ошибку, а потом поняли, что та же сигнатура сбоя появляется в посторонних приложениях Vulkan на той же версии драйвера. Исправили её на стороне NVIDIA, в драйвере 596.21. Теперь мы показываем более понятное сообщение об ошибке, но реальное исправление — «обновите драйвер».
Мобильные устройства: самый малый уровень и честность о разрыве
Мы включили локальный ИИ только на iPhone 15 Pro и новее (чип A17 Pro и выше) и на iPad с чипом M-серии или A17 Pro. Рассуждение простое: у более старых устройств нет ни унифицированной памяти, ни поколения Neural Engine, чтобы запускать даже самый малый уровень с приемлемой скоростью.
Даже на 15 Pro вы запускаете модели компактного уровня: Qwen 3.5 2B, Qwen 3.5 4B, Gemma 4 E2B. Квантованная модель на 2–5B параметров пишет совсем на другом уровне, чем модель на 9B. Хороша в структурированном выводе, хороша в следовании чётким инструкциям, приемлема в коротких резюме. На длинных встречах она теряет нить, особенно когда много говорящих или технического жаргона. Мы прямо говорим об этом в мобильном интерфейсе: локальная модель помечена соответствующим образом, а для серьёзного анализа встреч на телефоне мы рекомендуем облачный ИИ по умолчанию.
На Android и в вебе в версии 3.2 нет доступного пользователю режима локального ИИ. Обвязка Android FFI в кодовой базе есть (libllama.so собирается), но проверенного и ограниченного по условиям интерфейса для неё мы пока не выпустили. Разброс оборудования на Android и ограничения среды выполнения (нет аналога тесной интеграции Metal) пока не дают обещать единообразный опыт. Веб пока исключён: ограничения браузера по постоянному хранилищу, доступу к вычислениям GPU и объёму памяти остаются движущимися целями. Оба направления, вероятно, появятся позже. Ни одно не обещано.
Что остаётся локальным, а что нет
Смысл выпуска локального ИИ в том, чтобы человек мог провести встречу через Hedy, и ничто в ней не покинуло его компьютер. Мы отнеслись к этой цели серьёзно, а это значит быть точными в том, что куда идёт.
| Данные | Облачный ИИ (по умолчанию) | Локальный ИИ + синхронизация выкл. |
Локальный ИИ + синхронизация вкл. |
|---|---|---|---|
| Захват аудио | Только локально | Только локально | Только локально |
| Транскрипция | Только локально | Только локально | Только локально |
| ИИ-анализ (резюме, заметки, чат, подсказки) |
Уходит в облако | Только локально | Только локально |
| Хранение сессий | Локально + облако (зашифровано) |
Только локально | Локально + облако (зашифровано) |
| Данные аккаунта (электронная почта, подписка) |
Облако | Облако | Облако |
| Телеметрия и отчёты о сбоях | Облако (анонимно) |
Облако (анонимно) |
Облако (анонимно) |
Содержимое разговора (аудио, транскрипт, ИИ-анализ) попадает на наши серверы, только когда ИИ-работа идёт в облачном режиме, когда пользователь включил облачную синхронизацию или когда пользователь явно делится сессией. Облачная синхронизация, если она включена, — это слой синхронизации поверх уже зашифрованных данных сессии, а не запасной путь вывода. Сама ИИ-работа остаётся там, где её настроили.
То, что мы сознательно не стали создавать, — это молчаливый переход на облако. Если у вас включён локальный ИИ и локальный конвейер даёт сбой (модель падает, не хватает памяти посреди генерации, возникает ошибка вывода), ошибка доходит до вызывающей стороны. Тихой повторной попытки на наших серверах нет. Человек, включивший локальный ИИ, сделал это не просто так. Переход на облако без предупреждения предал бы допущение, которое он сделал, когда его включил.
Чего это стоит
Облачный ИИ по-прежнему лучше для большинства пользователей. Мы должны сказать это ясно, потому что технически подкованная аудитория этой статьи сразу распознает любой маркетинг на эту тему.
Облако быстрее для большинства пользователей, часто на порядок. Резюме, которое с нашим облачным конвейером готово за пару секунд, локально на модели стандартного уровня может занять 30 секунд, а на модели Pro-уровня на пограничной машине — несколько минут. Подсказки в реальном времени, которые срабатывают во время встречи, заметно отзывчивее в облачном режиме.
Есть честное исключение, о котором стоит сказать. На MacBook Pro топовой комплектации (например, M5 Max со 128 ГБ унифицированной памяти) с сильной локальной моделью сравнение может перевернуться. У облачного вывода тоже есть свои проблемы с задержкой: размещённые модели делят мощности GPU между многими пользователями, и время до первого токена может сильно вырасти, когда нагрузка высока или популярная модель стоит в очереди. У локальной модели, уже загруженной в память, такого разброса нет: она работает со скоростью, которую даёт ваше оборудование, детерминированно, каждый раз. Для пользователей с мощным оборудованием, выполняющих короткие запросы, пока облако занято, локальный режим действительно может выиграть по времени. Мы не хотим это преувеличивать (большинство пользователей на большинстве оборудования всё равно найдут облако в среднем быстрее), но об этом стоит сказать вслух: сравнение скорости не односторонне.
Облако работает на любой платформе. Локальный режим нет. Если вы на Android, в вебе или на более старом Mac или iPhone, локальный режим пока недоступен.
Причина, по которой большинство пользователей выберет локальный режим, — конфиденциальность, а не производительность. Мы старались сделать локальный режим достаточно хорошим, чтобы компромисс по конфиденциальности был настоящим, а не жестом, но на большинстве оборудования это именно компромисс. Выбирать локальный режим, потому что хотите держать встречи на своём компьютере, разумно. Выбирать его ради одной скорости имеет смысл, только если ваше оборудование это обеспечивает.
Отдельное замечание: автоматические подсказки — функция, которая непрерывно запускает LLM во время встречи, чтобы предвосхитить, что сказать дальше, — тяжёлая. Это самая затратная ИИ-нагрузка в Hedy. В облаке вы этого не замечаете. Локально, особенно на небольшой машине, она может загрузить цикл вывода до предела и замедлить остальной компьютер. Приложение показывает однократный диалог с рекомендацией, когда вы включаете параметр «Локальная обработка ИИ»: «Автоматические подсказки постоянно используют ИИ во время сессии. При локальной обработке данных это может нагружать центральный и графический процессоры, замедляя работу компьютера. Вы сможете снова включить их в любой момент в настройках.» Мы думали жёстко отключать автоматические подсказки в локальном режиме, но отказались от этого: обладатель мощной машины может их запустить, и мы не хотим решать за пользователей.
Архитектурные решения, о которых стоит поговорить
Несколько вещей, которые мы сделали намеренно и которые технически подкованному читателю могут показаться интересными.
Никакого молчаливого перехода на облако. Уже упоминалось. Цена для пользователя — время от времени непонятные ошибки. Зато функция делает ровно то, что обещает.
Настройка для каждого устройства. Настройки локального ИИ (какая модель выбрана, какие функции используют локальный режим) не синхронизируются между устройствами. На вашем Mac может стоять модель 9B, а на телефоне 2B, и настраиваются они отдельно. Синхронизация здесь была бы неправильной: нужная модель зависит от того, на каком оборудовании вы работаете, а не от абстрактных предпочтений пользователя.
Архивные модели остаются доступными, пока их не удалят. Когда модель в каталоге заменяется (например, Qwen 3.5 27B → Qwen 3.6 27B), мы помечаем старую запись архивной, а не удаляем. Те, кто уже скачал её, могут продолжать пользоваться; после удаления локального файла запись полностью исчезает из интерфейса. Мы не собираемся превращать скачанные 17 ГБ в бесполезный груз только потому, что каталог обновился.
Квантование как продуманный выбор, а не регулятор. Unsloth выпускает каждую модель в дюжине вариантов квантования: от Q2 до Q8, в вариантах K, K_M, K_L, XL и динамическими версиями. Показать их все было бы ловушкой. Большинство пользователей не отличит Q4_K_M от UD-Q4_K_XL, а спад качества на нижнем конце резкий. Мы выбираем конкретное квантование для каждой модели на основе баланса размера и качества именно для неё. Q4_K_M для большинства. Динамический UD-Q4_K_XL от Unsloth для 27B, где послойное квантование возвращает реальное качество при том же размере файла. Вариант Q8_0 «HQ» для 9B — для пользователей с запасом ОЗУ, которым нужен опыт, максимально близкий к fp16 из доступного в этом классе параметров. Метка «HQ» выбрана намеренно: вывод «Q8_0» в интерфейсе означал бы необходимость учить каждого пользователя, что такое квантование GGUF, а такой налог мы брать не хотим.
Помещаемость и скорость рассчитываются, а не угадываются. Каждая запись каталога проходит через алгоритм оценки на обнаруженном оборудовании, прежде чем попасть в список. Оценщик прикидывает требуемую память (веса + KV-кэш + рабочий буфер при квантовании модели из каталога) против реально доступной и оценивает токены в секунду по пропускной способности памяти GPU, когда она известна (со штрафами за частичную выгрузку на GPU и выполнение только на CPU). Из этого получается классификация помещаемости («Отлично подходит» / «Подходит впритык» / «Не поместится») и суффикс «+ Медленно», когда выполнение включает любую выгрузку на CPU. На Windows это очевидный случай: слои модели переливаются из видеопамяти в системную ОЗУ. На macOS тот же суффикс появляется, когда модель помещается только за счёт того, что ОС вытесняет другие приложения, чтобы закрепить в памяти веса: технически загружается, но вы это почувствуете. Бейдж «Рекомендуется» получает модель с самой высокой оценкой из тех, что попали в «Отлично подходит» (не «впритык»); мы намеренно не рекомендуем модели «впритык», даже если по сырому качеству они набрали бы больше: подталкивать человека к модели, которая работает заметно медленнее, чем должна, хуже, чем подталкивать к модели на ступень ниже, которая работает чисто.
Отмена, которая действительно работает. Генерация llama.cpp идёт в рабочем изоляте, чтобы поток интерфейса оставался отзывчивым, с потоковой передачей токенов обратно в главный изолят через NativeCallable.listener. Отмена проходит через llama_set_abort_callback, проверяющий атомарный флаг, и это сверено с исходным кодом вышестоящего проекта, а не угадано, так что пользователь, закрывающий сессию посреди долгой генерации, действительно останавливает работу, а не оставляет её дорабатываться в фоне и тратить заряд.
Чего мы пока не знаем
Честный список:
- У нас нет хороших реальных данных по задержкам для широкого спектра оборудования. Мы тщательно тестировали на машинах, которые у нас есть, опрашивали бета-тестеров и читали отчёты о сбоях, но длинный хвост «ноутбука на Windows с интегрированной графикой 2018 года» трудно охарактеризовать. Первые данные из эксплуатации покажут, где на самом деле шероховатости. В наших собственных тестах локальный вывод занимал от пяти секунд до пяти минут в зависимости от длины встречи, контекста и выбранной модели.
- Мы не знаем правильного ритма выпуска новых версий моделей. Текучесть каталога уже реальна (Qwen 3.5 → 3.6 за один цикл). До сих пор мы справлялись архивированием вместо удаления, но если совокупное использование диска выйдет из-под контроля, возможно, понадобится другая политика.
- Энергопотребление на ноутбуках удивит некоторых пользователей при непрерывной ИИ-нагрузке. Встреча с автоматическими подсказками, работающими локально, значительно требовательнее той же встречи с облачным ИИ. Адаптивного ограничения по заряду батареи у нас пока нет, и, вероятно, оно нужно. Случай, когда человеку просто нужно резюме в конце встречи, — совсем другое дело: это единичная одноразовая генерация, и на любой машине, которая комфортно запускает модель уровня Pro или Max, она укладывается в обычный запас по батарее и температуре.
Куда всё движется
Интересна не столько версия Hedy 3.2, сколько то, что кривые продолжают двигаться.
Модели с открытыми весами продолжают улучшаться на малых размерах. Класс 2B сегодня примерно там, где класс 7B был восемнадцать месяцев назад. Какими бы ни были следующие двенадцать месяцев у Gemma, Qwen и других серьёзных семейств с открытыми весами, нижняя планка того, что работает на обычном ноутбуке, продолжает расти.
Потребительское оборудование продолжает становиться мощнее. Поколения чипов Apple тихо встраивали вывод в дорожную карту кремния. Windows начинает поставлять NPU, которые со временем станут важны для вывода, хотя сегодняшнее первое поколение — по большей части маркетинговая история.
В сумме это тихий сдвиг. Раньше ИИ означал «горстка компаний управляет большими моделями от вашего имени, а вы отправляете им свои данные». Теперь он всё чаще означает: «горстка компаний обучает большие модели, но вы можете запускать их на собственном устройстве со своими данными, от начала до конца». Размещённая версия сегодня всё ещё лучше и, вероятно, будет ещё какое-то время. Но разрыв сокращается, и для значительной части пользователей «достаточно хорошо и локально» побеждает «лучшее и удалённое».
Hedy 3.2 — наша первая конкретная ставка на этот сдвиг. Архитектура построена так, чтобы мы могли двигать рычаг дальше по мере того, как позволяют модели и оборудование. Дальше будет больше.
About the author
Julian Pscheid is the founder and CEO of Hedy AI, a real-time AI meeting coach used by tens of thousands of professionals worldwide. He writes about how AI is changing the way people prepare for, capture, and understand important conversations.



