AI 노트 테이커는 회의의 개인정보를 얼마나 잘 보호하나요?
AI 노트 테이커는 회의를 외부 업체가 보관하는 기록으로 바꿉니다. 단계마다 어떤 데이터가 외부로 나가는지, 업체의 설명을 어떻게 확인하는지, 모든 처리를 기기에서 끝내는 방법을 알아보세요.
Associated Press는 2026년 7월 9일 직장에서 사용하는 AI 노트 테이커에 관한 기사에서 여러 위험을 짚었습니다(AP, 2026년 7월). 기밀 인사 정보, 기업 전략, 영업 비밀, 나중에 증언 녹취에서 불리하게 읽힐 발언 등이 그 예입니다. 조언도 현실적입니다. 회의에 AI 노트 테이커가 들어왔는지 확인하세요. 민감한 회의 전에는 동의를 구하세요. 개인이 직접 반대에 나서지 않아도 되도록 회사 방침을 근거로 삼으세요. 민감한 이야기를 할 때는 도구를 끄세요. 업체가 무엇을 보관하며 그중 모델 학습에 쓰는 정보가 있는지 물어보세요.
이 조언들은 모두 회의가 외부 업체의 기록으로 남을 때 생기는 문제에 대처하는 방법입니다. 회의를 꼭 외부 기록으로 남겨야 하는지는 묻지 않습니다. Baker Donelson의 기업 법무 변호사 Justin Daniels는 기사에서 이 점을 날카롭게 짚었습니다. “그 도구를 끄기 전에는 중요한 이야기는 시작도 하지 않습니다. 위험을 감수하고 싶지 않기 때문입니다.” 대부분이 쓰는 도구에는 적절한 조언입니다. 회의 내용이 기기 밖으로 나갈 수밖에 없다는 전제가 깔려 있습니다.
요즘 기기에서는 그럴 필요가 없습니다. 일부 제품은 전체 처리 과정을 사용자의 기기에서 실행할 수 있지만, 이 사실은 널리 알려져 있지 않습니다.
AI 노트 테이커를 쓰면 어떤 데이터가 외부로 나가나요?
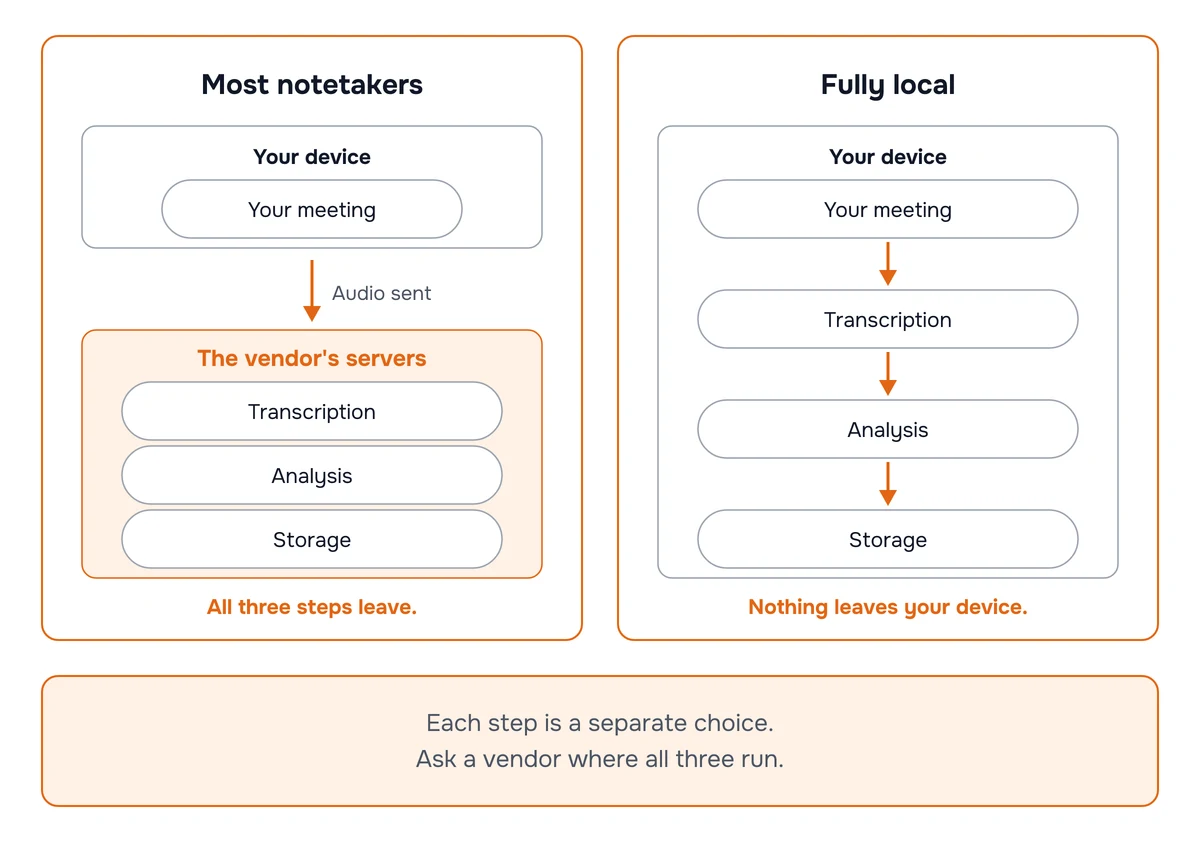
정보가 외부로 나갈 수 있는 단계는 세 가지이며, 각 단계에서 별도로 유출될 수 있습니다. 음성 텍스트 변환은 음성을 글로 옮깁니다. 분석은 그 텍스트를 읽어 요약과 실행 항목을 작성합니다. 저장 방식에 따라 이런 데이터가 직접 관리할 수 없는 곳에 남을 수도 있습니다. 각 단계는 사용자가 소유한 하드웨어에 남겨 두거나 외부로 보낼 수 있으므로 총 8가지 조합이 가능합니다.
| 단계 | 하는 일 | 기기에서 실행할 수 있나요? | 기기에서 처리하지 않을 때 외부로 나가는 데이터 |
|---|---|---|---|
| 음성 텍스트 변환 | 음성을 텍스트로 변환하며, 화자 레이블을 붙이는 경우도 있음 | 최신 하드웨어에서 가능 | 오디오 자체. 많은 시스템에서는 화자별 음향 임베딩도 전송 |
| 분석 | 녹취록을 읽어 요약과 실행 항목을 작성 | 성능이 충분한 하드웨어에서 가능 | 녹취록과 모델이 녹취록에서 추론한 모든 내용 |
| 저장 및 동기화 | 기록을 보관 | 동기화를 꺼 두면 가능 | 검색 가능한 장기 보관용 사본과 삭제 후에도 남을 수 있는 메타데이터 |
업체의 개인정보 보호 설명은 대개 이 구분을 흐립니다. “오디오가 기기 밖으로 나가지 않습니다”라는 말은 제품 전체에 대한 설명처럼 들립니다. 실제로는 음성 텍스트 변환만 기기에서 한다는 뜻이어서, 바로 다음 순간에 발언을 그대로 담은 녹취록 전체가 언어 모델로 전송될 수도 있습니다. Hedy도 기본적으로 이렇게 작동합니다. 그래서 오디오가 외부로 나가는지만 물어서는 부족합니다. 녹취록 자체가 회의 기록입니다. 녹취록이 기기 밖으로 나가면 보호하고 싶었던 내용 대부분도 함께 나갑니다.
Hedy의 기본 설정처럼 기기 내 처리와 클라우드 처리를 섞는 방식은 흔합니다. 문제는 어느 단계에서 데이터가 기기 밖으로 나가는지 업체가 알려 주지 않을 때입니다.
모든 단계를 기기에서 실행할 수 있나요?
요즘 하드웨어에서는 가능합니다. 이 점은 크게 주목받지 않은 채 달라졌습니다. 세 단계를 모두 기기에서 실행하는 제품은 드뭅니다.
음성 텍스트 변환은 비교적 쉬운 단계
기본 엔진인 Whisper는 Hedy가 지원하는 모든 플랫폼에서 실행됩니다. Nemotron은 웹 앱을 제외한 모든 네이티브 플랫폼에서 실행됩니다. Nemotron은 NVIDIA의 6억 파라미터 음성 모델을 기반으로 하는 스트리밍 엔진이며, 예전에는 클라우드 엔진을 선택하는 이유였던 화자 레이블도 붙입니다. 약 0.6~0.7 GB를 한 번 다운로드하면 Apple Silicon Mac, iPhone XS 이상, Neural Engine이 탑재된 iPad, Windows, 64비트 Android에서 실행할 수 있습니다. 억양, 실내 소음, 여러 사람이 동시에 말하는 상황, 전문 용어에 따라 정확도가 달라지므로 공개된 수치에 의존하기보다 실제 회의에서 시험해 보세요.
Nemotron은 누가 어떤 말을 했는지도 기기에서 파악합니다. 누군가를 소개하거나 이름으로 부르면 Hedy는 이제 화자 레이블에 실제 이름을 넣을 수 있습니다. Hedy 3.12부터는 지원되는 iPhone과 Apple Silicon Mac에서 세션이 끝난 뒤 NVIDIA의 Nemotron 3 Diarization으로 화자 레이블을 다시 확인합니다. NVIDIA에 따르면 이 모델은 VoiceArena 화자 구분 순위에서 1위에 올랐으며, 클라우드 서비스 3개를 포함한 Argmax 벤치마크의 6개 시스템 중 오류율이 가장 낮았습니다. 이 재확인도 기기에서 실행되므로 화자 레이블을 붙이기 위해 오디오를 서버로 보낼 필요가 없습니다.
분석에 필요한 하드웨어와 처리 시간
로컬 AI 처리는 기기에서 직접 요약과 제안을 생성합니다. 이를 실행하려면 Apple Silicon Mac, 충분한 성능의 GPU를 갖춘 Windows PC, 또는 최근 출시된 iPhone이나 iPad가 필요합니다. 모델 크기는 모바일용 약 1.2 GB부터 20 GB 이상까지 다양합니다. 파라미터가 약 90억 개인 중간급 모델은 메모리 16 GB인 Mac에서 무리 없이 실행됩니다. 가장 큰 모델에는 대략 25 GB 이상의 RAM이 필요합니다.
클라우드 분석이 더 빠르고 현재는 결과의 품질도 더 높아 로컬 AI 처리는 기본적으로 꺼져 있습니다. Hedy는 기본 설정에서 음성 인식을 항상 기기에서 실행하므로 사용자가 요청하지 않는 한 오디오가 기기 밖으로 나가지 않습니다. 한편 분석은 클라우드에서 실행하므로 언어 모델을 실행할 수 없는 기기에서도 원활하게 작동합니다. 클라우드에서 거의 즉시 나오는 요약도 기기에서 처리하면 30초에서 몇 분까지 걸릴 수 있습니다. 자세한 내용은 로컬 AI 기술 설명에서 확인할 수 있습니다.
로컬 AI 처리에 실패해도 알림 없이 클라우드로 전환하지 않습니다. 기기 내 처리에 문제가 생기면 오류를 표시하며, 서버에서 몰래 재시도하지 않습니다. 알림 없는 전환은 개인정보 보호 기능에서 특히 큰 문제입니다. 사용자가 막으려 했던 데이터 전송이 그대로 일어나는데도 이를 알 수 없기 때문입니다.
기본값과 완전한 기기 내 처리 사이에 선택지가 하나 더 있습니다. iOS 27을 실행하는 지원 대상 iPhone과 iPad에서는 분석을 Hedy의 파트너 대신 Apple Private Cloud Compute로 보낼 수 있습니다. Apple 계정으로 작동하고, 실패해도 다른 방식으로 자동 전환하지 않습니다. 다만 여전히 기기 밖에서 처리하고 Apple이 처리 지역을 보장하지 않으므로 EU 내 데이터 보관 요건을 충족하지 않습니다. EU 내 데이터 보관이 필요하다면 ‘Cloud AI’를 유지하세요. Hedy의 EU 데이터 리전 계정에서 ‘Cloud AI’를 사용하면 Inceptron이 EU 내에서 처리합니다. 계약상 콘텐츠 저장과 모델 학습은 금지됩니다.
저장 위치를 결정하는 동기화 설정
다른 기기에서도 볼 수 있다는 편리함 때문에 기록이 어디에 저장되는지 놓치기 쉽습니다. ‘클라우드 동기화’는 다른 기기에서도 세션 데이터를 볼 수 있도록 Hedy 서버에 복사합니다. 켜 두면 기기 내 처리와 여러 기기에서의 접근을 함께 사용할 수 있습니다. 꺼 두면 해당 세션을 명시적으로 공유하는 경우에만 대화 내용이 Hedy 서버로 전송됩니다. 기기 내 처리와 기기 내 저장은 각각 결정해야 합니다. 기기 내 처리만 지원하는 도구에서는 모든 단계가 기기 안에서 끝나지 않습니다.
공유를 통해서도 콘텐츠가 기기 밖으로 나갑니다. 공개 공유 링크를 만들면 선택한 섹션이 웹페이지에 표시되며, 주소를 아는 사람은 계정 없이도 열 수 있습니다. 오디오는 포함되지 않으며 만료일을 정하거나 링크를 취소할 수 있습니다. 다만 목록에 공개되지 않을 뿐 주소를 전달할 수 있으므로 비공개 링크는 아닙니다. 기밀 내용은 이메일 초대로 공유해 받는 사람이 로그인하도록 하세요.
AI 노트 테이커의 개인정보 보호 설명은 어떻게 확인하나요?
도구가 어떻게 작동하는지 살펴본 뒤 문서를 읽으세요. 한 가지만으로는 충분하지 않습니다.
비행기 모드에서 시험해 보세요. 네트워크 연결을 끄고 세션을 시작하세요. 도구가 계속 음성을 텍스트로 변환하고 요약한다면 기기 내에서 처리할 수 있다는 뜻입니다. 여러 단서 중 하나로 보세요. 작동이 멈춘 이유는 클라우드가 필요해서일 수도 있고, 로그인이나 모델 다운로드가 필요해서일 수도 있습니다. 오프라인에서 잘 작동하는 도구도 다시 연결되는 순간 모든 데이터를 서버로 보낼 수 있습니다. 이 테스트로 기기 내 처리 모드가 있다는 사실은 확인할 수 있지만, 온라인에서 어떻게 작동하는지는 알 수 없습니다.
화자 레이블을 어디서 붙이는지 물어보세요. 화자 레이블을 표시하는 도구가 데이터를 기기 밖으로 보내지 않는다고 설명한다면, 어떤 기기 내 엔진으로 화자를 구분하는지 물어보세요. 업체가 엔진 이름을 댈 수 있다면 구체적인 답을 준 셈입니다. 답하지 못한다면 서버에서 레이블을 붙이고 있을 수 있습니다.
재위탁 업체 목록을 읽어 보세요. 개인정보 처리방침은 이용자가 안심할 수 있도록 작성됩니다. 재위탁 업체 목록은 구매 검토와 계약상 고지를 위해 마련되므로 데이터 처리에 관여하는 업체를 이름으로 밝힙니다. Hedy의 목록은 trust.hedy.ai에서 확인할 수 있습니다. 어느 업체의 목록이든 어떤 회사가 왜 회의 내용을 받을 수 있는지 살펴보세요. 목록의 길이만으로는 알 수 있는 것이 거의 없습니다.
삭제 후에 무엇이 남는지 물어보세요. Fisher Phillips의 파트너 변호사 Danielle Kays는 콘텐츠를 삭제해도 업체에 회의 메타데이터가 남을 수 있으며, 모델이 입력받은 콘텐츠를 기억하거나 재현하는 경우도 있다고 지적했습니다. 삭제가 무엇을 뜻하는지는 업체마다 다릅니다. 흔히 “삭제”란 사용자의 화면에서 항목을 없앤다는 뜻입니다.
확인이 꼭 필요하다면 트래픽을 검사하세요. 오프라인 테스트와 개인정보 보호 페이지는 서로 다른 질문에 답하지만, 어느 쪽도 네트워크에서 실제로 오가는 데이터를 보여 주지는 않습니다. 규제를 받는 환경에 도입한다면 패킷이나 DNS를 검사해 도구가 실제로 무엇을 보내는지 확인할 수 있습니다.
설치 전에 무엇을 물어봐야 하나요?
다음 다섯 가지 질문에는 각각 구체적인 답이 필요합니다.
- 세 단계는 각각 어디에서 실행되나요? 음성 텍스트 변환, 분석, 저장을 하나씩 짚어 물어보세요. “개인정보는 보호되나요?”라는 질문만으로는 부족합니다.
- 화자 레이블을 만들며, 어디에서 생성하나요? 서버에서 처리한다면 임베딩에 어떤 정보가 담기는지, 얼마나 오래 보관하는지, 참가자에게 무엇을 고지하는지 물어보세요.
- 보관 기간과 파기 일정은 어떻게 되나요? 기간을 명시한 서면 답변을 받으세요. 일리노이주는 바로 이 내용을 요구하며, 아래에 인용한 변호사들에 따르면 이 도구를 도입하는 회사 대부분이 그런 일정을 마련하지 않았습니다.
- 재위탁 업체는 어느 회사이며 어느 지역에 있나요? 유럽 참가자가 있다면 이 역시 GDPR 관련 질문입니다. 최근 EU와 미국 간 데이터 이전 관련 변화로 이전의 법적 근거가 전보다 불확실해졌습니다.
- 처리에 실패하면 클라우드로 전환하나요? 전환 사실을 알리나요? 알림 없이 전환하면 개인정보 보호 설정이 제 역할을 하지 못합니다.
AI 노트 테이커에서 “데이터를 보관하지 않는다”는 말의 의미는 무엇인가요?
대개 문구에서 기대하는 것보다 적용 범위가 좁습니다. “데이터를 전혀 보관하지 않는다”는 말은 보통 처리 과정에 관여하는 한 업체, 대개 요약을 작성하는 AI 제공업체만 가리킵니다. AI 노트 테이커 업체 자체의 저장 방식이나 백업에 대해서는 아무것도 알려 주지 않습니다. 각각 물어보세요.
AI 제공업체. 데이터 미보관 계약을 맺은 모델 제공업체는 요청에 응답하기 위해 녹취록을 처리한 뒤 아무것도 보관하지 않습니다. Hedy의 클라우드 AI 파트너도 이렇게 운영합니다. 계약상 사용자 콘텐츠를 학습에 사용할 수 없으며, 요청 처리가 끝나면 콘텐츠를 보관하지 않습니다.
도구 업체의 자체 서버. 이곳에는 회의 기록이 저장됩니다. 여러 기기에서 접근하려면 기록이 필요하므로 대부분의 AI 노트 테이커는 기본적으로 기록을 보관합니다. Hedy는 ‘클라우드 동기화’를 켰거나 세션을 명시적으로 공유한 두 경우에만 서버에 세션 데이터를 저장합니다. Hedy는 정해진 일정에 따라 삭제하지 않으므로 동기화된 세션은 직접 삭제하거나 계정을 삭제할 때까지 남습니다. 이 역시 보관 정책이며, 삭제 시점은 사용자가 정합니다. 동기화로 데이터가 보관되는 것을 원하지 않으면 ‘클라우드 동기화’를 끄세요.
백업. 세션을 삭제하면 앱에서 사라지고 백업은 별도 일정에 따라 삭제됩니다. Hedy는 동기화된 데이터의 재해 복구용 백업을 14일간 보관하며, 개별 세션을 복원하는 데 사용하지 않습니다. 따라서 삭제된 세션이 백업에 최대 2주 동안 남을 수 있습니다. 어느 업체든 백업 보관 기간을 물어보세요. 그래야 삭제가 언제 완료되는지 알 수 있습니다.
도구의 개인정보 보호 페이지에서 세 가지를 모두 다루지 않는다면, 기밀 고객 문서나 대화 내용을 입력하기 전에 개인정보 처리방침 원문을 읽어 보세요. 아래 Heppner 사건에서 보듯 법원도 그 방침을 들여다볼 수 있습니다.
데이터를 기기 밖으로 보내지 않고 Hedy를 사용하려면 어떻게 하나요?
기본값 하나를 확인하고 설정 두 가지를 바꾸세요.
설정 → 음성 및 AI를 여세요. Whisper 또는 Nemotron이 선택되어 있는지 확인하세요. Whisper가 기본값이므로 대부분은 이미 설정되어 있습니다. 클라우드 제공업체로 전환한 경우에만 이 설정을 바꾸면 됩니다.
같은 화면에서 AI 처리를 로컬 AI로 설정하고 ‘적합 ✓’ 레이블이 붙은 모델을 선택하세요. Hedy는 사용 가능한 메모리를 확인해 각 모델에 ‘적합 ✓’, ‘간신히 적합’, ‘적합하지 않음’ 중 하나를 표시하므로 추측할 필요가 없습니다. 이 설정은 기기마다 다르므로 Mac과 iPhone에서 각각 모델을 선택해야 합니다.
그런 다음 클라우드 동기화를 끄세요. 이 설정을 끄면 세션을 명시적으로 공유하는 경우에만 회의 데이터가 Hedy 서버로 전송됩니다.
하드웨어에서 로컬 모델을 실행할 수 없다면 ‘AI 처리’를 끄기로 설정하세요. AI 처리 옵션 비교: Cloud AI, 로컬 AI, 끄기에서 각 옵션을 비교할 수 있습니다. 기기 내 음성 텍스트 변환은 계속 작동하므로 AI가 생성하는 노트 없이 비공개 녹취록을 얻을 수 있습니다. 개인정보 보호 설정 안내에는 가능한 설정 조합이 모두 나와 있으며, 보안 페이지에는 각 구성이 설명되어 있습니다.
개인정보를 보호하는 AI 노트 테이커를 써도 동의가 필요한가요?
그렇습니다. 기기에서 실행되는 도구는 봇보다 다른 사람이 알아차리기 어렵습니다.
AP는 참가자가 회의 플랫폼과 별개로 개인용 기록 기기를 사용할 수 있으며, “그럴 경우 다른 참석자는 대화가 녹음되고 텍스트로 변환된다는 사실을 모를 수 있다”고 지적했습니다. 봇은 참가자 목록에 표시됩니다. 누군가의 휴대전화에서 실행되는 앱은 아무 표시도 남기지 않습니다. 그래서 알리지 않고 녹음하기가 더 쉽습니다. Hedy 같은 도구에 대한 타당한 지적입니다. Electronic Frontier Foundation의 선임 보안 및 개인정보 보호 분석가 Thorin Klosowski는 이렇게 답했습니다. “민감한 회의를 하기 전에 모두에게 동의를 구하는 것이 가장 예의 바른 방법입니다.”
로컬 처리는 데이터가 어디로 가는지를 결정합니다. 참가자의 동의 여부는 별개입니다. 녹음 관련 법률과 직장 내 방침, 직업상 의무는 어떤 방식으로 처리하든 그대로 적용됩니다. 다른 사람이 볼 수 없는 도구를 사용한다면 그 사실을 알릴 책임은 더 커집니다.
다만 동의를 구하는 대화는 한결 쉬워집니다. 녹음에 대한 거부감은 대개 노트 자체보다 기록의 보관 방식에서 나옵니다. 누가 더 볼 수 있는지, 얼마나 오래 남는지, 업체가 인수되면 어떻게 되는지가 걱정인 것입니다. “제 노트북에만 저장되고 회의가 끝나면 지우겠습니다”라고 말하는 것과 “약관을 읽어 보지 않은 서비스에 업로드됩니다”라고 말하는 것은 다릅니다. 말을 꺼내기 어려울 때 그대로 읽어도 되는 동의 요청 문구를 참고하세요. 녹음 관련 법률과 동의에서는 관할 지역별 쟁점을 다룹니다.
The Dillon Law Group의 소속 변호사 Chris Pluymers는 AI 노트 테이커 사용을 거절할 때 쓸 문구도 제안했습니다. “이번 회의에서는 AI 녹음이나 음성 텍스트 변환 도구를 사용하지 않았으면 합니다. 필요하면 제가 직접 메모하고 요약을 공유하겠습니다.” 인사 전문가 인증기관 HRCI의 최고경영자 Amy Dufrane은 개인 차원의 반대가 되지 않도록 회사 방침을 근거로 제시하라고 권했습니다.
녹취록은 왜 녹음보다 더 위험한가요?
Klosowski는 AP 기사에서 이 점을 날카롭게 짚었습니다. “영상이 많으면 저장하기가 쉽지 않습니다. 비용이 많이 들고 훑어보기도 어렵죠. 텍스트는 검색하기 훨씬 쉽고 저장 비용도 더 낮습니다.”
AI 노트 테이커가 나오기 전에는 녹음의 번거로움 자체가 실질적인 보호 장치였습니다. 2시간짜리 회의는 녹음도 2시간입니다. 이유 없이 재생 위치를 이리저리 옮겨 가며 내용을 훑는 사람은 없고, 저장 비용도 들기 때문에 결국 녹음 파일을 삭제하게 됩니다. 보안 예산을 따로 들이지 않아도 이런 번거로움이 기록을 보호했습니다.
녹취록에서는 그 장벽이 사라집니다. 텍스트는 저장 비용이 낮아 계속 보관할 수 있고, 저장하는 즉시 검색할 수 있습니다. 접근 권한이 있다면 증거개시 명령을 받은 상대 측 변호사를 포함해 누구든 4년치 기록에서 검색 한 번으로 특정 문구가 나온 모든 대목을 찾아낼 수 있습니다. 아무도 재생하지 않은 녹음에 묻혔을 발언이 검색 결과로 나타납니다.
그렇다고 모든 면에서 녹취록이 더 위험한 것은 아닙니다. 오디오에는 말투와 배경 대화처럼 텍스트에 남지 않는 정보가 있고, 목소리를 복제하기에 충분한 음성도 담길 수 있습니다. 오디오는 나중에도 텍스트로 변환할 수 있으므로 녹음은 아직 글로 옮기지 않은 녹취록이기도 합니다. 달라진 점은 “누군가 찾아낼 수도 있다”에서 “누군가 바로 찾아낼 수 있다”로 바뀌었다는 것입니다. 대부분은 그 차이를 위험을 판단할 때 고려하지 않았습니다.
성문이란 무엇이며 누가 보유하나요?
Pluymers는 화자 1과 화자 2를 구별하기 위해 많은 AI 노트 테이커가 목소리마다 음향 특성을 추출한다고 설명했습니다. 이 과정을 화자 구분이라고 합니다. 많은 독자가 미처 생각하지 못했을 문제는 여기서 시작됩니다.
성문에 대한 법적 판단 현황
일리노이주의 생체정보 개인정보 보호법에서는 성문을 생체 식별자로 봅니다. 이 법은 서면 고지와 사용 목적 및 보관 기간 공개, 수집 전 서명된 동의서, 문서화된 파기 일정을 요구합니다(740 ILCS 14/15). 화자 구분을 위한 임베딩이 여기에 해당하는지는 법원에서 다투기 시작한 쟁점이며, 확립된 법 해석은 아닙니다(Lewis Rice). 일부 종단 간 화자 구분 시스템은 영구적인 템플릿을 만들지 않고 오디오를 익명의 화자 번호에 연결하는 방식으로 작동합니다.
실제 소송도 진행 중입니다. AI 회의 도구는 일리노이주 생체정보 개인정보 보호법(BIPA)에 따른 집단소송의 대상이 되고 있습니다(Fisher Phillips). Fireflies.ai를 상대로 집단소송을 청구한 원고들은 회사가 가입한 적 없는 사람까지 포함해 회의 참가자의 음성을 녹음하고 텍스트로 변환해 저장하면서, 법이 요구하는 고지, 동의 및 보관 관련 보호 조치를 갖추지 않았다고 주장합니다(Jackson Lewis). 이는 아직 입증되지 않은 주장입니다. 2026년 8월 말 기준 일리노이 북부 연방지방법원의 병합 사건은 여전히 소송 기각 신청 단계에 있었고, Fireflies는 8월 26일 재답변서를 제출했습니다(사건 기록). 업체들도 정책에 성문 관련 내용을 명시하고 있습니다. 2026년 8월 16일에 갱신된 Fathom의 개인정보 처리방침에는 iOS에서 선택적으로 성문을 수집한다고 나와 있습니다(Fathom).
유출된 성문으로 할 수 있는 것과 없는 것
우려가 과장되어 퍼지기도 하지만, 훔친 화자 구분 임베딩만으로 은행 계좌에 접근할 가능성은 낮습니다. 음성 인증을 쓰는 은행은 자체 템플릿을 등록하며, 업체가 내부적으로 쓰는 임베딩은 은행 템플릿과 호환되도록 만들어지지 않았습니다. 더 현실적인 위험은 누군가의 목소리를 그럴듯하게 복제할 수 있을 만큼 녹음된 오디오가 남는 것입니다(FTC). 이는 임베딩이 아니라 오디오 자체의 문제입니다.
기기 내 화자 구분이 위험을 줄이는 이유
기기 내 화자 구분에 적용해 볼 만한 선례가 있습니다. Barnett v. Apple 사건에서 일리노이주 항소법원은 Face ID와 Touch ID에 관한 BIPA 집단소송의 기각 결정을 유지했습니다. 생체정보가 사용자의 기기 밖으로 나가거나 Apple 서버에 전송된 적이 없고, 해당 기능은 선택 사항이며 데이터를 삭제할 수 있었으므로 Apple이 생체정보를 보유하거나 수집하지 않았다고 판단했습니다(Duane Morris, IAPP). 기기 내 화자 구분도 이와 비슷합니다. 기기에서 정보를 추출하며 외부로 전송하지 않고, 사용 여부를 선택할 수 있으며 데이터를 삭제할 수 있습니다. Hedy의 Nemotron 엔진과 세션이 끝난 뒤 실행하는 Nemotron 3 Diarization 재확인이 모두 이 방식으로 작동합니다.
이 판례가 면책을 보장하지는 않습니다. Barnett의 결론은 그 사건의 사실관계에 따른 것입니다. 설계나 소장에서 제기한 주장이 다르면 결과도 달라질 수 있으며, 회의 소집자의 의무에 대해서는 판단하지 않았습니다. 판례는 이러한 방식으로 위험을 줄일 수 있다는 근거가 됩니다. 이 내용은 법률 자문이 아닙니다.
AI 노트 테이커가 변호사와 의뢰인 간 비밀유지 특권에 영향을 줄 수 있나요?
미국 연방법원은 AI가 생성한 문서에 비밀유지 특권이 적용되지 않는다고 판단한 바 있습니다.
법원의 판단
United States v. Heppner 사건에서 뉴욕 남부 연방지방법원의 Jed Rakoff 판사는 2026년 2월, 형사 피고인이 변호인에게 받은 정보를 챗봇에 입력해 만든 문서가 변호사와 의뢰인 간 비밀유지 특권이나 소송 준비 자료 보호 원칙의 적용을 받지 않는다고 판단했습니다. 챗봇은 피고인의 프롬프트를 바탕으로 피고인 자신의 방어 전략 개요를 포함해 문서 31개를 생성했습니다(Harvard Law Review). Rakoff 판사는 세 가지 이유를 제시했습니다. 챗봇은 “명백히 변호사가 아니고”, 챗봇 자체의 고지문에는 출력물을 법률 자문으로 취급하지 말라고 명시되어 있어 법률 자문을 받는 것이 주된 목적이었다는 주장의 설득력이 떨어졌습니다. 또한 업체가 공개한 개인정보 처리방침에는 소송 과정에서 사용자 정보가 공유될 수 있다고 적혀 있어, 사용자가 개인정보가 보호되리라고 합리적으로 기대할 수 없었습니다(Dorsey).
두 번째 이유는 다시 읽어 볼 만합니다. 개인정보 처리방침은 피고인을 보호하는 근거가 아니라 판단에 쓰인 증거였습니다. 업체가 자체 데이터 처리 방식을 설명하기 위해 작성한 문서가 사용자의 비밀유지 기대가 합리적이지 않다고 본 근거가 됐습니다.
판결이 적용되는 범위
Heppner 판결은 회의용 AI 노트 테이커를 사용하면 비밀유지 특권을 포기하는 셈인지 판단하지 않았습니다. 비밀유지 특권이 적용되는 대화에 도구가 참여한 사건이 아니라, 피고인이 자발적으로 챗봇을 사용한 사건입니다. 이 판결이 AI 노트 테이커에 어떤 의미를 갖는지는 여전히 논의 중입니다(Columbia Blue Sky). 뉴욕시 변호사협회는 AI로 의뢰인과의 대화를 녹음하고 텍스트로 변환하는 행위의 윤리에 관한 공식 의견에서 녹음과 보관을 별개의 문제로 봅니다(NYC Bar Formal Op. 2025-6).
다만 더 좁은 범위에서 적용할 수 있는 경고는 남습니다. 기밀 자료를 제3자에게 보내면 기밀이 유지되리라고 기대하기 어려워질 수 있습니다. 처리 과정에 제3자가 없으면 이 문제는 생기지 않습니다. 그렇다고 비밀유지 특권이 생기거나, 증거개시를 막을 수 있거나, 부적절하게 녹음한 대화가 정당해지는 것은 아닙니다. Daniels는 실무에서의 위험을 이렇게 설명했습니다. “데이터가 다른 곳으로 넘어가는데 당사자가 그 사실을 모른다면, 변호사와 의뢰인 간 비밀유지 특권이 적용되던 대화도 더 이상 보호받지 못할 수 있습니다.”
어떤 회의에서 모든 단계를 기기에서 처리할 필요가 있나요?
모든 회의에 필요한 것은 아닙니다. 항상 필요하다고 하면 이 조언 자체가 설득력을 잃습니다.
매주 하는 짧은 진행 상황 회의에는 기본 클라우드 설정으로 충분합니다. 녹취록 자체가 부담이 되는 회의라면 요약이 느려져도 모든 단계를 기기에서 처리할 만합니다. 법률 상담, 인사 조사, 이사회나 거래 관련 논의, 녹취록에 이름이 남는 것만으로도 취재원의 일자리가 위태로워질 수 있는 인터뷰, 환자가 의사의 말을 나중에 다시 확인하려고 자신의 진료를 녹음하는 경우가 이에 해당합니다. 회의 외에도 기기에서 직접 실행하는 도구를 알아보고 싶다면 로컬 AI 도구 7가지 비교를 참고하세요.
사람마다 한 가지 방식을 고정하기보다 회의마다 판단하세요. 대부분의 회의에는 기본 클라우드 설정을 써도 됩니다. 녹취록 자체가 피해를 줄 수 있는 몇몇 회의에서는 모든 단계를 기기에서 처리하도록 설정하고, 통화 전에 작동을 확인한 뒤 참가자에게 어떤 도구를 쓰는지 알리세요.
자주 묻는 질문
클라우드에 아무것도 보내지 않고 AI 노트 테이커를 사용할 수 있나요?
가능합니다. 다만 모든 단계를 자체 하드웨어에서 실행할 수 있는 도구는 많지 않습니다. AI 노트 테이커는 음성을 텍스트로 변환하고, 녹취록을 분석하고, 결과를 저장합니다. 각 단계에서 정보가 별도로 유출될 수 있습니다. Fireflies와 Granola를 비롯한 많은 클라우드 기반 AI 노트 테이커는 세 단계 모두 외부 서버에서 실행합니다. Hedy는 지원하는 모든 플랫폼에서 기본적으로 기기에서 직접 음성을 텍스트로 변환하며, 최신 하드웨어 대부분에서는 분석도 기기에서 실행할 수 있습니다. ‘클라우드 동기화’를 끄면 세션을 명시적으로 공유하는 경우에만 회의 데이터가 Hedy 서버로 전송됩니다.
오디오가 기기 밖으로 나가지 않는지만 확인하면 충분한가요?
아니요. 가장 흔한 오해입니다. “오디오가 외부로 전송되지 않는다”는 말은 세 단계 중 음성 텍스트 변환이 기기에서 이뤄진다는 뜻일 뿐입니다. 기기에서 음성을 텍스트로 변환한 뒤 녹취록을 언어 모델로 보내는 도구도 있습니다. Hedy의 기본 설정도 그렇습니다. 녹취록은 발언을 그대로 옮긴 기록이므로 기기 밖으로 보내면 오디오를 보낼 때와 거의 같은 문제가 생깁니다. 마이크에만 국한하지 말고 각 단계가 어떻게 처리되는지 물어보세요.
AI 노트 테이커는 회의 참가자의 성문을 생성하나요?
누가 발언했는지 레이블을 붙이는 과정에서 성문을 만드는 도구도 있습니다. 많은 화자 구분 시스템이 화자를 구별하기 위해 목소리마다 음향 임베딩을 추출합니다. 이 임베딩이 일리노이주 생체정보 개인정보 보호법의 규제를 받는 성문에 해당하는지는 아직 소송에서 다투는 쟁점이며, 모든 시스템이 이런 방식으로 작동하는 것도 아닙니다. 레이블을 어디에서 붙일지는 선택할 수 있습니다. 기기 내 화자 구분은 데이터를 전송하지 않습니다. Hedy는 화자 레이블을 기기에서 붙이고, 지원되는 iPhone과 Mac에서 NVIDIA의 Nemotron 3 Diarization으로 세션 종료 후 레이블을 재확인하는 작업도 기기에서 실행합니다.
기기 내 처리로 생체정보 관련 개인정보 보호 위험이 사라지나요?
위험을 줄일 수 있으며, 이를 뒷받침하는 판례가 있습니다. Barnett v. Apple 사건에서 일리노이주 항소법원은 사용자 생체정보가 각자의 기기에 남아 Apple 서버로 전송되지 않았고, 해당 기능은 선택 사항이며 데이터를 삭제할 수 있었으므로 Apple이 생체정보를 보유하거나 수집하지 않았다고 판단했습니다. 로컬 처리에 의미 있는 선례지만, 해당 사건의 구체적인 사실관계에 따른 판단입니다. 위험은 줄어들지만 면책이 보장되지는 않으며, 회의 소집자의 의무에 대해서는 아무런 판단도 내리지 않았습니다.
AI 도구가 변호사와 의뢰인 간 비밀유지 특권에 영향을 줄 수 있나요?
미국 연방법원은 AI가 생성한 문서에 비밀유지 특권이 적용되지 않는다고 판단한 바 있습니다. United States v. Heppner 사건에서 Jed Rakoff 판사는 피고인이 변호인에게 받은 정보를 챗봇에 입력해 만든 문서가 비밀유지 특권이나 소송 준비 자료 보호의 대상이 아니라고 판단했습니다. 업체의 개인정보 처리방침에 소송 과정에서 정보가 공유될 수 있다고 명시한 점도 판단 근거였습니다. 피고인이 스스로 챗봇을 사용한 사건이므로 회의용 AI 노트 테이커에도 같은 판단이 적용되는지는 여전히 열린 문제입니다. 담당 변호사와 상의하세요.
클라우드 동기화를 끄면 AI 노트 테이커로 회의 내용을 비공개로 유지할 수 있나요?
그것만으로는 충분하지 않습니다. 동기화는 저장 여부를 결정하며, 처리 방식은 별개입니다. 자체 서버에 아무것도 저장하지 않는 도구라도 처리 과정에서 오디오를 음성 텍스트 변환 API로, 녹취록을 언어 모델로 보낼 수 있습니다. 저장, 음성 텍스트 변환, 분석은 각각 따로 확인해야 합니다. 업체가 저장에 대해서만 답했다면 나머지 두 단계에 대해서는 답하지 않은 셈입니다.
AI 노트 테이커가 기기에서 실행되는지 어떻게 확인하나요?
비행기 모드는 첫 확인에 유용하지만, 그것만으로 입증되지는 않습니다. 오프라인에서도 계속 음성을 텍스트로 변환한다면 기기 내 처리 경로가 있는 것입니다. 작동이 멈춘다면 클라우드가 필요할 수도 있고, 단순히 로그인이나 모델 다운로드가 필요할 수도 있습니다. 오프라인에서 기기 내 처리가 가능한 도구도 다시 온라인이 되면 클라우드를 사용할 수 있습니다. 오프라인 테스트와 함께 업체의 재위탁 업체 목록을 살펴보고, 확인이 꼭 필요하다면 네트워크 트래픽도 검사하세요.
기기 내 음성 텍스트 변환은 실제 회의에 쓸 만큼 정확한가요?
일상적인 회의에는 충분히 쓸 만합니다. Hedy의 Nemotron 엔진은 NVIDIA의 6억 파라미터 스트리밍 음성 모델을 기반으로 합니다. 모든 처리가 기기에서 이뤄지며 누가 어떤 말을 했는지 레이블을 붙입니다. 지원되는 iPhone과 Apple Silicon Mac에서는 NVIDIA의 Nemotron 3 Diarization으로 이 레이블을 다시 확인합니다. NVIDIA에 따르면 이 모델은 VoiceArena 화자 구분 순위에서 1위입니다. 억양, 주변 소음, 여러 사람이 동시에 말하는 상황, 전문 용어에 따라 정확도가 달라집니다. Hedy를 포함해 어느 업체의 벤치마크든 그대로 믿기보다 실제 회의에서 시험해 보세요.
기기에서 실행되는 AI 노트 테이커는 회의 봇보다 투명성이 낮나요?
그렇습니다. Hedy 같은 도구가 불리한 부분입니다. 봇은 참가자 목록에 표시됩니다. 개인 휴대전화에서 실행하는 앱은 아무 표시도 남기지 않으므로 몰래 녹음하기가 더 쉽습니다. Associated Press도 이 점을 직접 지적했습니다. 로컬 처리는 데이터가 어디로 가는지를 결정합니다. 참가자의 동의를 얻는 일은 별도의 의무이며, 로컬에서 처리하더라도 지켜야 합니다.
Hedy는 기본적으로 어떤 데이터를 클라우드로 보내나요?
모든 플랫폼에서 음성 인식은 기기에서 실행되므로 기본적으로 오디오는 기기 밖으로 나가지 않습니다. 요약과 제안을 생성하는 분석 단계는 기본적으로 클라우드에서 실행됩니다. 이때 녹취록은 일시적으로만 처리되며 모델 학습에 사용되지 않습니다. EU 데이터 리전 계정의 경우 스웨덴의 Inceptron을 통해 EU 내에서 처리합니다. 지원 기기 범위와 결과물 품질을 고려해 클라우드를 기본값으로 정했습니다. 로컬 AI 처리로 분석을 기기로 옮길 수 있으며, ‘클라우드 동기화’를 끄면 아무것도 동기화되지 않습니다.
Hedy는 회의 데이터를 보관하나요?
동기화하거나 공유한 경우에만 보관합니다. Hedy의 클라우드 AI 파트너는 요청에 응답하기 위해 녹취록을 처리하고, 처리가 끝나면 아무것도 보관하지 않습니다. 계약상 이 데이터를 모델 학습에 사용할 수도 없습니다. Hedy는 ‘클라우드 동기화’가 켜져 있거나 세션을 공유할 때만 자체 서버에 세션 데이터를 저장합니다. Hedy가 정해진 일정에 따라 삭제하지 않으므로 동기화된 세션은 직접 삭제할 때까지 남아 있습니다. 동기화된 데이터의 재해 복구용 백업은 14일간 보관합니다. ‘클라우드 동기화’를 끄면 세션을 공유한 경우에만 Hedy 서버에 해당 세션 데이터가 저장됩니다.
로컬 처리에 추가 요금이 드나요?
아니요. 기기 내 음성 인식과 로컬 AI 처리는 제품에 기본으로 포함되며, 개인정보 보호를 위한 별도 요금제가 필요하지 않습니다. 무료 요금제는 월 300분을 제공하며, Pro는 월 $12.99 또는 연 $99.99입니다. 로컬 모델은 한 번만 다운로드하면 되고 분당 요금이 없으므로 모든 단계를 기기에서 처리할 때 별도의 사용료가 들지 않습니다. 현재 요금제는 가격 안내에서 확인하세요.
About the author
Julian Pscheid is the founder and CEO of Hedy AI, a real-time AI meeting coach used by tens of thousands of professionals worldwide. He writes about how AI is changing the way people prepare for, capture, and understand important conversations.