Насколько приватен ваш ИИ-секретарь для встреч?
ИИ-секретари превращают встречу в запись, которая хранится у кого-то другого. Узнайте, что уходит с устройства на каждом шаге, как проверить заявления сервиса и как оставить всё локально.
9 июля 2026 года агентство Associated Press опубликовало материал об ИИ-секретарях на работе, где риски описаны хорошо (AP, июль 2026): конфиденциальные кадровые сведения, корпоративная стратегия, коммерческие тайны, реплики, которые потом плохо выглядят в показаниях под присягой. Советы там тоже разумные. Проверьте, не подключился ли секретарь. Попросите согласия перед важной встречей. Сошлитесь на политику компании, чтобы возражать не пришлось кому-то одному. Отключайте инструмент на деликатной части. Спросите, что сервис хранит и обучается ли на этом.
Все эти меры помогают справиться с последствиями того, что ваша встреча становится записью, которая хранится у кого-то другого. Ни одна не спрашивает, обязательно ли это. Justin Daniels, корпоративный юрист Baker Donelson, дал в материале самую точную формулировку: «Я не начну обсуждать ничего существенного, пока его не выключат, потому что просто не хочу рисковать». Для инструментов, которыми пользуется большинство, это правильный совет, и он исходит из того, что встреча обязана покинуть ваше оборудование.
На современных устройствах это не так. Небольшое число продуктов может выполнить весь конвейер на вашем собственном компьютере, и об этом знают немногие.
Что уходит с устройства, когда вы пользуетесь ИИ-секретарём?
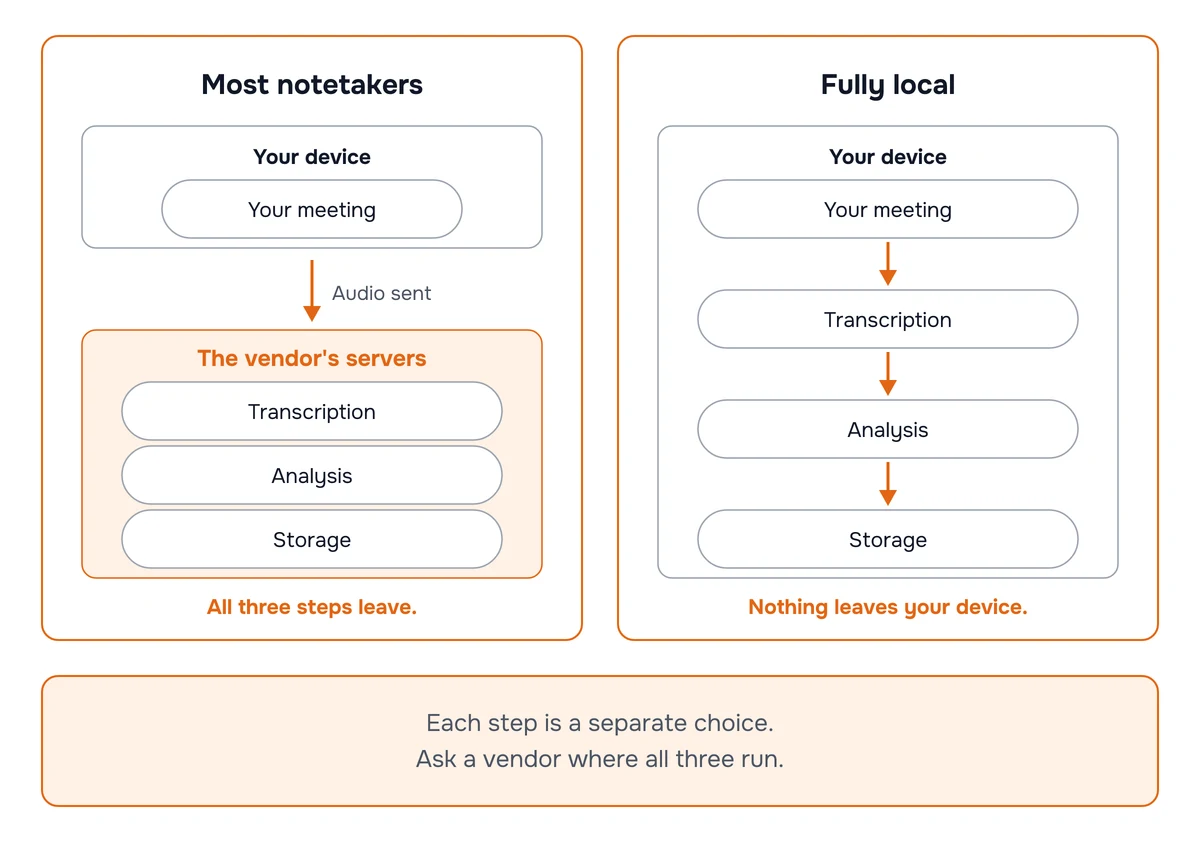
Три вещи, и утечь они могут независимо друг от друга. Расшифровка превращает аудио в текст. Анализ читает этот текст и пишет резюме и список задач. Хранение решает, останется ли что-то в месте, которое вы не контролируете. Каждый из шагов может остаться на вашем оборудовании или уйти к кому-то другому, а значит, возможны восемь сочетаний.
| Шаг | Что он делает | Можно ли выполнить на устройстве? | Что уходит, если нельзя |
|---|---|---|---|
| Расшифровка | Превращает аудио в текст, иногда с метками говорящих | Да, на современном оборудовании | Само аудио, а во многих системах ещё и акустическое представление каждого говорящего |
| Анализ | Читает транскрипт, пишет резюме и списки задач | Да, на мощном оборудовании | Транскрипт и всё, что модель из него выводит |
| Хранение и синхронизация | Хранит архив | Да, если не включать | Долговечная копия с поиском и метаданные, которые могут пережить удаление |
Здесь и прячется большинство заявлений о приватности. «Аудио никогда не покидает ваше устройство» звучит как утверждение обо всём продукте. На деле оно означает лишь, что расшифровка локальная, и вполне совместимо с отправкой полного дословного транскрипта в языковую модель секундой позже. Именно так Hedy и поступает по умолчанию, поэтому вопрос «уходит ли аудио» — неправильное место, где можно остановиться. Транскрипт и есть запись. Когда он покинул ваш компьютер, покинуло его и большинство того, чего вы опасались.
Гибридная обработка распространена, в том числе по умолчанию в Hedy. Проблема в сервисе, который не говорит, какие шаги покидают ваше устройство.
Может ли весь конвейер работать на вашем устройстве?
Да, на современном оборудовании, и именно эта часть незаметно изменилась. Все три шага выполняет всё меньше продуктов.
Расшифровка — шаг попроще
Whisper, движок по умолчанию, работает на всех платформах, где есть Hedy. Nemotron работает на всех нативных платформах, кроме веб-приложения. Nemotron — потоковый движок на основе речевой модели NVIDIA с 600 млн параметров, и он добавляет метки говорящих, из-за отсутствия которых раньше люди обращались к облачному движку. Ему нужна разовая загрузка примерно 0,6–0,7 ГБ, и он работает на Mac с Apple Silicon, iPhone XS и новее, iPad с Neural Engine, Windows и 64-разрядных Android. Точность по-прежнему зависит от акцента, шума в помещении, перебивания и специальной лексики, поэтому проверьте её на собственных встречах, а не по каким-либо опубликованным цифрам.
Nemotron к тому же определяет на устройстве, кто что сказал, и Hedy теперь умеет подставлять настоящие имена говорящих, когда человека представили или назвали по имени. Начиная с Hedy 3.12 поддерживаемые iPhone и Mac с Apple Silicon после завершения сессии ещё и перепроверяют метки говорящих с помощью Nemotron 3 Diarization от NVIDIA. По данным NVIDIA, эта модель занимает первое место в рейтинге диаризации VoiceArena и показала наименьшую ошибку среди шести систем в тесте Argmax, включая три облачных сервиса. Эта проверка тоже идёт на устройстве, так что для разметки говорящих не нужно отправлять аудио на сервер.
Анализ — здесь и кроется компромисс
Локальная обработка ИИ выполняет составление резюме и подсказок на вашем компьютере и требует серьёзного оборудования: Mac с Apple Silicon, ПК с Windows и мощной видеокартой или недавнего iPhone либо iPad. Модели занимают от примерно 1,2 ГБ для мобильного уровня до более чем 20 ГБ. Модель среднего уровня с примерно 9 миллиардами параметров свободно умещается на Mac с 16 ГБ. Самым крупным нужно примерно 25 ГБ оперативной памяти и больше.
Локальная обработка ИИ по умолчанию отключена, потому что облачный анализ быстрее и пока даёт лучшие результаты. Выбор Hedy по умолчанию — осознанное разделение: распознавание речи везде локальное, чтобы аудио не уходило без вашей просьбы, а анализ в облаке, чтобы продукт хорошо работал на оборудовании, которое не потянет языковую модель. Резюме, которое в облаке появляется мгновенно, локально может занять от тридцати секунд до нескольких минут. Полный разбор есть в инженерном обзоре.
Локальная обработка ИИ не переключается втихую на облако. Если что-то не сработало локально, вы получите сообщение об ошибке, а не незаметный повторный запрос к серверу. Тихое переключение — худшее свойство, какое может быть у функции приватности: она отказывает именно в том направлении, которого вы пытались избежать, и ничего вам не сообщает.
Между вариантом по умолчанию и полностью локальным есть ещё один. На подходящих iPhone и iPad с iOS 27 анализ можно отправлять в Apple Private Cloud Compute, а не партнёрам Hedy. Он работает под вашей учётной записью Apple и тоже не переключается втихую на другой вариант. Но он всё равно выполняется вне устройства, а Apple не обязуется обрабатывать данные в определённом регионе, поэтому он не удовлетворит требование о хранении данных в ЕС. Если ваше ограничение — резидентность в ЕС, оставайтесь на «Облачном ИИ»: для аккаунтов в регионе данных Hedy в ЕС облачный ИИ обрабатывается в ЕС у Inceptron по договору, который исключает хранение содержимого и обучение на нём.
Хранение — это переключатель, а не функция
Шаг, о котором забывают, — архив, потому что он приходит под видом удобства. «Синхронизация с облаком» копирует данные сессий на серверы Hedy, чтобы их видели ваши другие устройства. Оставьте её включённой, и вы получите доступ с разных устройств при локальной обработке. Отключите, и ничего из разговора не попадёт на наши серверы, пока вы явно не поделитесь этой сессией. Локальная обработка и локальное хранение — разные решения, и сервис, который предлагает только первое, конвейер не замыкает.
Делиться — другой путь, которым содержимое покидает устройство. Публичная ссылка размещает выбранные вами разделы на веб-странице, которую может открыть любой, у кого есть адрес, без аккаунта. Она никогда не включает аудио, и вы можете задать срок действия или отозвать её, но она лишь не публикуется в открытых списках, а не приватна: адрес можно переслать. Для всего конфиденциального делитесь по приглашению на электронную почту, чтобы получателю пришлось войти в аккаунт.
Как проверить заявления ИИ-секретаря?
Наблюдайте за поведением, затем читайте документы. По отдельности ни того ни другого недостаточно.
Попробуйте режим полёта. Отключите сеть и запустите сессию. Если сервис продолжает расшифровывать и составлять резюме, локальный путь существует, и это полезно знать. Считайте это одним из признаков, а не доказательством: зависание может означать, что сервису нужен вход в аккаунт или загрузка модели, а не облако, а сервис с рабочим офлайн-режимом всё равно может пропустить всё через сервер, как только вы снова подключитесь. Это говорит лишь о том, что локальный режим существует. Что происходит при подключении к сети, это не говорит.
Обратите внимание на вопрос о метках говорящих. Если сервис показывает метки говорящих и утверждает, что ничего не покидает ваше устройство, спросите, какой движок на устройстве выполняет диаризацию. Если поставщик может его назвать, он сообщает вам что-то реальное. Если не может, возможно, разметка идёт на сервере.
Прочитайте список субподрядчиков. Политика конфиденциальности написана так, чтобы успокаивать. Список субподрядчиков существует для закупок и договорных уведомлений, поэтому в нём названы компании, участвующие в цепочке. Список Hedy опубликован на trust.hedy.ai. Читайте список любого поставщика, чтобы понять, какие компании могут получать содержимое встреч и зачем; одна лишь длина списка мало что говорит.
Спросите, что переживает удаление. Danielle Kays, партнёр Fisher Phillips, отметила, что метаданные встреч могут оставаться у поставщика после удаления содержимого, а загруженное содержимое в некоторых случаях может запоминаться или воспроизводиться моделью. Что значит «удалить», зависит от поставщика, и часто это означает «убрать из вида, который вам доступен».
Если это действительно важно, проверьте трафик. Офлайн-тесты и страницы о приватности отвечают на разные вопросы, и ни те ни другие не следят за сетью. Для регулируемого внедрения именно анализ пакетов или DNS показывает, что сервис на самом деле отправляет.
О чём спросить перед установкой?
Пять вопросов. Ответ на каждый должен быть конкретным.
- Где выполняется каждый из трёх шагов? Расшифровка, анализ, хранение — названные по отдельности. А не «это приватно?».
- Создаёте ли вы метки говорящих и где? Если на сервере, спросите, что это за представление, как долго оно хранится и какое уведомление получают участники.
- Каков график хранения и уничтожения? В письменном виде, со сроком. Иллинойс требует именно этого, и, по словам цитируемых ниже юристов, у большинства компаний, внедряющих такие инструменты, его нет.
- Кто субподрядчики и где они находятся? Это и вопрос по GDPR, если среди участников есть европейцы; недавние события вокруг передачи данных между ЕС и США сделали правовое основание менее надёжным, чем раньше.
- Переключается ли сервис на облако при сбое, и сообщает ли об этом? Тихое переключение превращает настройку приватности в украшение.
Что значит «данные не хранятся» для ИИ-секретаря?
Обычно меньше, чем кажется. «Нулевое хранение» чаще всего относится к одному участнику цепочки, как правило, к ИИ-провайдеру, который пишет резюме, и ничего не говорит о собственном хранилище поставщика и его резервных копиях. Спрашивайте про каждое из них.
ИИ-провайдер. Соглашение о нулевом хранении означает, что поставщик модели обрабатывает транскрипт, чтобы ответить на запрос, и потом ничего не хранит. Облачные ИИ-партнёры Hedy работают так: наши соглашения запрещают им обучаться на вашем содержимом, и после выполнения запроса они его не хранят.
Собственные серверы поставщика. Это архив, и большинство ИИ-секретарей по умолчанию его хранят, потому что от него зависит доступ с разных устройств. Hedy хранит данные сессий на своих серверах лишь в двух случаях: когда включена «Синхронизация с облаком» или когда вы явно делитесь сессией. Hedy ничего не удаляет по расписанию, поэтому синхронизированные сессии остаются, пока вы не удалите их или свой аккаунт. Это тоже политика хранения, просто такая, которую вы контролируете. Если не хотите хранения совсем, отключите «Синхронизацию с облаком».
Резервные копии. Удаление сессии убирает её из приложения, а резервные копии следуют своему графику. Hedy хранит резервные копии синхронизированных данных для аварийного восстановления 14 дней и не использует их для восстановления отдельных сессий, поэтому удалённая сессия может сохраняться в резервной копии до двух недель. Спросите это число у любого поставщика, потому что оно говорит, когда удаление становится окончательным.
Если страница о приватности сервиса не охватывает все три пункта, прочитайте саму политику, прежде чем загружать конфиденциальные документы клиентов или разговоры. Как показывает дело Heppner ниже, суд тоже может её прочитать.
Как запустить Hedy так, чтобы ничего не уходило?
Проверьте одну настройку по умолчанию, затем измените две.
Откройте «Настройки» → «Речь и ИИ». Убедитесь, что выбран Whisper или Nemotron. Whisper уже выбран по умолчанию, поэтому у большинства всё уже сделано; трогать это нужно, только если кто-то переключил на облачного провайдера.
На том же экране установите «Обработка ИИ» в значение «Локальный ИИ» и выберите модель с пометкой «Отлично подходит ✓». Hedy проверяет доступную память и помечает каждую модель как «Отлично подходит ✓», «Подходит впритык» или «Не поместится», так что гадать не придётся. Настройка действует для каждого устройства отдельно, поэтому Mac и iPhone нужно настраивать по отдельности.
Затем отключите «Синхронизацию с облаком». Когда она отключена, данные встреч не попадают на наши серверы, пока вы явно не поделитесь сессией.
Если ваше оборудование не потянет локальную модель, установите «Обработка ИИ» в значение «Отключено» («Обработка ИИ: облачный ИИ, локальный ИИ или отключено» сравнивает варианты). Локальная расшифровка продолжит работать, и вы получите приватный транскрипт без заметок, созданных ИИ. Обзор настроек разбирает всю матрицу, а страница о безопасности описывает каждую конфигурацию.
Нужно ли согласие, если секретарь приватный?
Да. Инструмент на устройстве другим людям заметить труднее, чем бота.
AP отметило, что участники могут пользоваться личными устройствами для заметок независимо от платформы встречи, «и тогда остальные участники не обязательно будут знать, что обсуждение записывают и расшифровывают». Бот отображается в списке участников. Приложение на чьём-то телефоне не отображается нигде. Из-за этого тайную запись вести проще, и это справедливая критика той категории, к которой относимся мы. Thorin Klosowski, старший аналитик по безопасности и приватности в Electronic Frontier Foundation, ответил прямо: «Спросить у всех согласия перед деликатной встречей было бы самым вежливым подходом».
Локальная обработка определяет, куда уходят данные. О том, согласился ли кто-то, она ничего не говорит. Законы о записи, политики на работе и профессиональные обязанности никуда не деваются из-за архитектуры, а использование инструмента, которого никто не видит, повышает обязанность сказать о нём.
Легче становится разговор. Сопротивление записи чаще связано не с заметками, а с архивом: кто ещё это увидит, как долго оно будет жить, что будет, когда поставщика купят. «Это остаётся на моём ноутбуке, и потом я удалю» — совсем другой разговор, чем «это загружается в сервис, условия которого я не читал». Для неловкого случая мы написали готовые формулировки для запроса согласия, а юридическую сторону в разных юрисдикциях разбирает статья «Законы о записи и согласие».
Chris Pluymers, младший юрист The Dillon Law Group, тоже предложил формулировку для отказа от секретаря: «Я предпочёл бы вести эту встречу без ИИ-записи и инструментов расшифровки, а сам с удовольствием буду делать заметки и поделюсь резюме, если это поможет». Amy Dufrane, исполнительный директор сертифицирующей HR-организации HRCI, предложила сделать это вопросом организации, а не личным делом, сославшись на политику компании, чтобы возражать не пришлось кому-то одному.
Почему транскрипты рискованнее записей?
Klosowski сделал в материале AP самое точное наблюдение: «Хранить кучу видео непросто, это дорого и в нём трудно искать, а текст гораздо легче искать и дешевле хранить».
До появления ИИ-секретарей практической защитой записи было неудобство. Двухчасовая встреча — это двухчасовой объект. Без причины никто его не просматривает, а хранение стоит достаточно дорого, чтобы записи удаляли. Это неудобство выполняло настоящую работу по безопасности, которую никому не приходилось закладывать в бюджет.
Транскрипты его убирают. Текст достаточно дёшев, чтобы хранить его вечно, и доступен для поиска с момента появления. Один запрос по архивам за четыре года выдаёт каждое вхождение фразы любому, у кого есть доступ, в том числе противной стороне с судебным предписанием о раскрытии. Реплика, которая исчезла бы в непросмотренной записи, становится результатом поиска.
Впрочем, это не однозначное повышение опасности. В аудио есть то, что теряет текст: интонация, фоновые разговоры и достаточно вашего голоса, чтобы его клонировать. Аудио к тому же можно расшифровать позже, так что запись — это транскрипт, который ещё не появился. Сдвиг происходит от «кто-то может это найти» к «кто-то может найти это мгновенно», и большинство людей никогда не оценивало эту разницу.
Что такое голосовой отпечаток и у кого хранится ваш?
Pluymers описал механизм: чтобы отличить говорящего 1 от говорящего 2, многие ИИ-секретари выводят для каждого голоса акустическую подпись. Этот процесс называется диаризацией, и это та нить, о которой большинство читателей не задумывалось.
Что говорит закон
В Иллинойсе голосовые отпечатки — биометрические идентификаторы по закону о биометрической информации (BIPA), который требует письменного уведомления, раскрытия цели и срока хранения, подписанного согласия до сбора и документированного графика уничтожения (740 ILCS 14/15). Считается ли представление, полученное при диаризации, таким идентификатором, пока формирующаяся теория, которую проверяют в суде, а не установленная норма (Lewis Rice). Некоторые сквозные модели диаризации вообще работают иначе: они сопоставляют аудио с анонимными номерами говорящих, не создавая постоянного шаблона.
Судебные споры реальны. ИИ-секретари для встреч — активная цель коллективных исков по BIPA (Fisher Phillips), а Fireflies.ai — ответчик по предполагаемому коллективному иску, где утверждается, что сервис записывает, расшифровывает и хранит голоса участников, в том числе людей, которые никогда не регистрировались, без требуемых уведомления, согласия и мер защиты при хранении (Jackson Lewis). Это лишь утверждения. По состоянию на конец августа 2026 года объединённое дело в Северном округе Иллинойса всё ещё находилось на стадии ходатайства об отклонении иска, а Fireflies подала ответ 26 августа (судебная карточка). Поставщики тоже начинают вписывать голосовые отпечатки в свои политики: в политике конфиденциальности Fathom, обновлённой 16 августа 2026 года, описан необязательный сбор голосовых отпечатков на iOS (Fathom).
Что украденный голосовой отпечаток может и чего не может
Пугающая версия широко ходит, поэтому её стоит сузить: украденное представление, полученное при диаризации, вряд ли само по себе сработает как ключ к вашему банковскому счёту. Банки, использующие голосовую верификацию, создают собственные шаблоны, а внутреннее представление поставщика не рассчитано на взаимозаменяемость с ними. Реальный голосовой риск обыденнее: достаточно записанного аудио, чтобы убедительно клонировать человека (FTC). Это довод про аудио, а не про представление.
Почему диаризация на устройстве меняет риск
У диаризации на устройстве есть полезный прецедент. В деле Barnett v. Apple апелляционный суд Иллинойса подтвердил отклонение коллективного иска по BIPA из-за Face ID и Touch ID, указав, что Apple не владела биометрическими данными пользователей и не собирала их, поскольку они никогда не покидали их устройства, не отправлялись на серверы Apple, а функции были добровольными и удаляемыми (Duane Morris, IAPP). Это близко соответствует локальной диаризации: данные получены на вашем устройстве, нигде не передаются, необязательны и удаляемы. Движок Nemotron в Hedy работает именно так, как и перепроверка Nemotron 3 Diarization после сессии.
Это не гарантия полной защиты. Решение по Barnett основано на конкретных фактах, другая конструкция или другая формулировка иска могли бы привести к другому исходу, и оно ничего не говорит об обязанностях того, кто созвал встречу. Это снижение риска с хорошим прецедентом, и ничто из этого не является юридической консультацией.
Может ли ИИ-секретарь повлиять на адвокатскую тайну?
Федеральный суд счёл, что документы, созданные ИИ, адвокатской тайной не защищены.
Что постановил суд
В деле United States v. Heppner судья Jed Rakoff из Южного округа Нью-Йорка в феврале 2026 года постановил, что документы, которые обвиняемый по уголовному делу создал, загрузив в чат-бот информацию от своих адвокатов, не защищены ни адвокатской тайной, ни доктриной рабочих материалов адвоката. Инструмент создал по его запросам 31 документ, включая набросок стратегии его собственной защиты (Harvard Law Review). Rakoff назвал три причины: чат-бот «явно не адвокат»; его собственные оговорки предупреждали, что результат нельзя считать юридической консультацией, и это подрывает довод о том, что основной целью была юридическая консультация; а опубликованная политика конфиденциальности сервиса предупреждала, что информация пользователя может быть передана в рамках судебных споров, поэтому у пользователя не было разумного ожидания приватности (Dorsey).
Над вторым пунктом стоит подумать ещё раз. Политика конфиденциальности не была защитой. Она была доказательством. Документ, который поставщик написал, чтобы описать собственную работу с данными, стал причиной, по которой ожидание конфиденциальности у пользователя сочли неразумным.
Как далеко это заходит
Heppner не решал, лишает ли ИИ-секретарь для встреч адвокатской тайны. Дело касалось подсудимого, который сам воспользовался чат-ботом, а не инструмента, присутствующего на конфиденциальной беседе, и комментаторы всё ещё разбираются, что оно значит для таких секретарей (Columbia Blue Sky). У Ассоциации юристов Нью-Йорка есть официальное заключение об этике ИИ-записи и расшифровки разговоров с клиентами, которое рассматривает запись и хранение как отдельные проблемы (NYC Bar Formal Op. 2025-6).
Более узкое предупреждение всё же остаётся в силе: отправка конфиденциальных материалов третьей стороне может ослабить ожидание, что они останутся конфиденциальными. В конвейере без третьей стороны этот вопрос не возникает. Но такой конвейер не создаёт адвокатской тайны, не исключает раскрытия документов в суде и не делает запись, сделанную с нарушением, допустимой. Daniels сформулировал практическую версию прямо: «если данные уходят куда-то ещё и они об этом не знают, эта беседа, защищённая адвокатской тайной, может перестать ею быть».
Каким встречам нужна полностью локальная настройка?
Не всем, и если делать вид, что всем, совет легко отбросить.
Для еженедельной планёрки облако по умолчанию подходит. Полностью локальная настройка стоит более медленного резюме, когда сам транскрипт и есть угроза: юридические консультации, кадровые расследования, обсуждения совета директоров и сделок, интервью с источниками, где имя в транскрипте — чья-то работа, и пациенты, которые записывают собственные приёмы у врача, чтобы позже вспомнить, что сказал врач. Если вам нужен более широкий взгляд на инструменты, работающие на устройстве, не только для встреч, мы сравнили семь локальных ИИ-инструментов.
Правильный выбор делается для каждой встречи, а не для каждого человека. Большинство встреч может использовать облако по умолчанию. Для немногих, где вредным оказался бы сам транскрипт, запустите полностью локальную конфигурацию, проверьте её до звонка и скажите, что вы используете.
Часто задаваемые вопросы
Можно ли пользоваться ИИ-секретарём, ничего не отправляя в облако?
Да, но только с теми немногими сервисами, которые выполняют каждый шаг на вашем оборудовании. ИИ-секретарь расшифровывает аудио, анализирует транскрипт и сохраняет результат. Утечь может на любом из этих шагов независимо от других, а многие облачные сервисы, среди них Fireflies и Granola, выполняют все три на чужих серверах. Hedy по умолчанию расшифровывает речь на устройстве на всех платформах, где работает, а на большинстве современных устройств может и анализ выполнять на устройстве. Если «Синхронизация с облаком» отключена, данные встречи не попадают на наши серверы, пока вы сами явно не поделитесь сессией.
Достаточно ли проверить, что аудио не покидает моё устройство?
Нет, и это самая частая ошибка. Фраза «аудио не покидает устройство» говорит лишь о том, что расшифровка локальная, а это один шаг из трёх. Сервис может расшифровывать речь на вашем устройстве и всё равно отправлять транскрипт в языковую модель, именно так Hedy и работает по умолчанию. Транскрипт — это дословная запись, поэтому его отправка с устройства поднимает почти те же вопросы, что и отправка аудио. Спрашивайте про каждый шаг, а не только про микрофон.
Создают ли ИИ-секретари голосовые отпечатки участников встречи?
Некоторые создают, как побочный эффект разметки говорящих. Многие системы диаризации извлекают для каждого голоса акустическое векторное представление, чтобы различать говорящих. Считается ли это представление регулируемым голосовым отпечатком по закону Иллинойса о биометрической информации (BIPA), пока предмет активных судебных споров, а не установленная норма, и не все системы работают именно так. Вы можете контролировать, где происходит разметка: диаризация на устройстве ничего не передаёт. Hedy размечает говорящих на устройстве, включая повторную проверку после сессии с помощью NVIDIA Nemotron 3 Diarization на поддерживаемых iPhone и Mac.
Снимает ли обработка на устройстве риски, связанные с биометрическими данными?
Снижает, и за этим стоит реальная судебная практика. В деле Barnett v. Apple апелляционный суд Иллинойса постановил, что Apple не владела биометрическими данными пользователей и не собирала их: они оставались на устройствах, никогда не отправлялись на серверы Apple, а функции были необязательными и удаляемыми. Это весомый прецедент в пользу локальной обработки, но он основан на конкретных обстоятельствах. Это снижение риска, а не полная защита, и он ничего не говорит об обязанностях того, кто созвал встречу.
Может ли ИИ-инструмент повлиять на адвокатскую тайну?
Федеральный суд счёл, что документы, созданные ИИ, адвокатской тайной не защищены. В деле United States v. Heppner судья Jed Rakoff установил, что документы, которые подсудимый создал, загрузив в чат-бот информацию от своих адвокатов, не защищены ни адвокатской тайной, ни доктриной рабочих материалов, отчасти потому, что политика конфиденциальности сервиса предупреждала о возможной передаче информации в рамках судебных споров. Речь шла о чат-боте, которым подсудимый пользовался самостоятельно, а не о секретаре для встреч, поэтому дело не решает вопрос о таких секретарях. Проконсультируйтесь со своим юристом.
Делает ли отключение облачной синхронизации ИИ-секретаря приватным?
Само по себе нет. Синхронизация определяет хранение, а не обработку. Сервис может ничего не хранить на своих серверах и при этом по пути отправить ваше аудио в API расшифровки, а транскрипт в языковую модель. Хранение, расшифровка и анализ — это отдельные вопросы, и сервис, ответивший только про хранение, не ответил на остальные.
Как проверить, работает ли ИИ-секретарь локально?
Режим полёта — полезная первая проверка, но не доказательство. Если сервис продолжает расшифровывать речь офлайн, локальный путь существует. Если он зависает, это может означать, что ему нужно облако, а может быть, что ему просто нужен вход в аккаунт или загрузка модели. К тому же сервис с локальным офлайн-режимом всё равно может отправлять данные в облако, когда вы снова подключитесь к сети. Дополните проверку офлайн списком субподрядчиков сервиса и, если это действительно важно, анализом сетевого трафика.
Достаточно ли точна расшифровка на устройстве для реальных встреч?
Для обычных встреч она работает хорошо. Движок Nemotron в Hedy построен на потоковой речевой модели NVIDIA с 600 млн параметров, работает полностью на устройстве и определяет, кто что сказал. На поддерживаемых iPhone и Mac с Apple Silicon Hedy затем перепроверяет эту разметку с помощью NVIDIA Nemotron 3 Diarization, которая, по данным NVIDIA, занимает первое место в рейтинге диаризации VoiceArena. Точность по-прежнему зависит от акцента, фонового шума, перебивания и специальной лексики, поэтому проверьте её на собственных встречах и не доверяйте ничьим тестам, включая наши.
Менее ли прозрачен секретарь на устройстве, чем бот на встрече?
Да, и этот довод работает против таких сервисов, как наш. Бот объявляет о себе в списке участников. Приложение на чьём-то телефоне ничего не объявляет, и потому тайная запись становится проще, а не сложнее. Об этом прямо написало агентство Associated Press. Локальная обработка определяет, куда уходят данные, и ничего не говорит о том, согласились ли люди. Это разные обязанности, и вторую из них вы по-прежнему должны выполнять.
Что Hedy отправляет в облако по умолчанию?
Распознавание речи выполняется на вашем устройстве на всех платформах, поэтому по умолчанию аудио не уходит. Шаг анализа, на котором пишутся резюме и подсказки, по умолчанию выполняется в облаке: содержимое транскрипта обрабатывается временно и не используется для обучения моделей. Для аккаунтов в регионе данных ЕС эта обработка идёт в ЕС, у Inceptron в Швеции. Облако по умолчанию — осознанный компромисс ради охвата устройств и качества результата. Вы можете перенести анализ на устройство с помощью локальной обработки ИИ и отключить «Синхронизацию с облаком», чтобы ничего не синхронизировалось.
Хранит ли Hedy данные моих встреч?
Только если вы синхронизируете их или делитесь ими. Облачные ИИ-партнёры Hedy обрабатывают транскрипт, чтобы ответить на каждый запрос, и после этого ничего не хранят, а наши соглашения запрещают им обучаться на нём. Данные сессий Hedy хранит на своих серверах только при включённой «Синхронизации с облаком» или когда вы делитесь сессией. Синхронизированные сессии остаются, пока вы их не удалите, потому что Hedy ничего не удаляет по расписанию, а резервные копии синхронизированных данных для аварийного восстановления хранятся 14 дней. При отключённой «Синхронизации с облаком» на серверах Hedy нет данных сессий, пока вы не поделитесь ими.
Стоит ли локальная обработка дополнительных денег?
Нет. Распознавание речи на устройстве и локальная обработка ИИ входят в продукт, а не продаются как тариф за приватность. В бесплатный тариф входят 300 минут в месяц, а Pro стоит $12.99 в месяц или $99.99 в год. Локальные модели скачиваются один раз, а не оплачиваются поминутно, поэтому полностью локальный сценарий не требует затрат на использование. Актуальные тарифы смотрите на странице цен.
About the author
Julian Pscheid is the founder and CEO of Hedy AI, a real-time AI meeting coach used by tens of thousands of professionals worldwide. He writes about how AI is changing the way people prepare for, capture, and understand important conversations.



