AIメモツールはどこまで安全? 会議の取り扱いを検証
AIメモツールは、会議を他社が保管する記録に変えます。各ステップで何が外部に出るのか、ツールの主張の確かめ方、すべてをローカルで完結させる方法を解説します。
Associated Pressは2026年7月9日、職場のAIメモツールについての記事を掲載し、リスクをよく整理しています(AP、2026年7月)。人事に関する機密情報、企業戦略、営業秘密、後で証言録取の場で不利に響く発言などです。助言も妥当です。メモツールが参加していないか確認する。機微な会議の前に同意を求める。会社の方針を根拠にして、個人が反対役にならずに済むようにする。繊細な場面ではツールをオフにする。ベンダーが何を保持するか、そのうち何かを学習に使うかを尋ねる。
これらはどれも、会議が他社の保管する記録になるという結果への対処です。そうならずに済む方法があるのかは、どれも問いません。Baker Donelsonの企業法務弁護士、Justin Daniels氏は、この記事で最も鋭い一言を述べています。「ツールが切られるまでは、実質的な話は一切始めません。リスクを取りたくないからです。」多くの人が使っているツールには、これが正しい助言であり、会議がハードウェアの外に出ることが前提になっています。
最近のデバイスでは、その前提は成り立ちません。パイプライン全体を自分のマシン上で実行できる製品はごくわずかにあり、あまり知られていません。
メモツールを使うと、何が外に出るのか
3つあり、それぞれ別々に漏れ得ます。文字起こしは、音声をテキストに変えます。分析は、そのテキストを読み、要約とアクションアイテムを書きます。保管は、そのどれかが自分の管理できない場所に残り続けるかどうかを決めます。それぞれ、自分のハードウェアにとどめることも、他社に移すこともできるので、組み合わせは全部で8通りになります。
| ステップ | 何をするか | デバイス上で実行できるか | 実行できない場合に外へ出るもの |
|---|---|---|---|
| 文字起こし | 音声をテキストに変換し、話者ラベルが付くこともある | はい、最近のハードウェアなら可能 | 音声そのもの。多くのシステムでは、話者ごとの音響埋め込みも |
| 分析 | 文字起こしを読み、要約とアクションアイテムを書く | はい、十分な性能のハードウェアなら可能 | 文字起こしと、そこからモデルが推測する内容すべて |
| 保管と同期 | アーカイブを保持する | はい、同期をオフにしておけば可能 | 検索可能で長期にわたるコピーと、削除後も残り得るメタデータ |
プライバシーに関する主張の多くは、ここに隠れています。「音声はデバイスの外に出ません」は、製品全体についての説明に聞こえます。実際には、文字起こしがローカルだという意味にすぎず、その直後に文字起こしの全文を言語モデルに送ることとも両立します。Hedyもデフォルトでは、まさにそうしています。だから「音声が外に出るか」という問いで止まってはいけません。文字起こしこそが記録です。それが手元のマシンを離れれば、心配していたことのほとんども手元を離れています。
ハイブリッド処理は一般的で、Hedyのデフォルトもそうです。問題になるのは、どのステップがデバイスの外に出るのかを説明しないベンダーです。
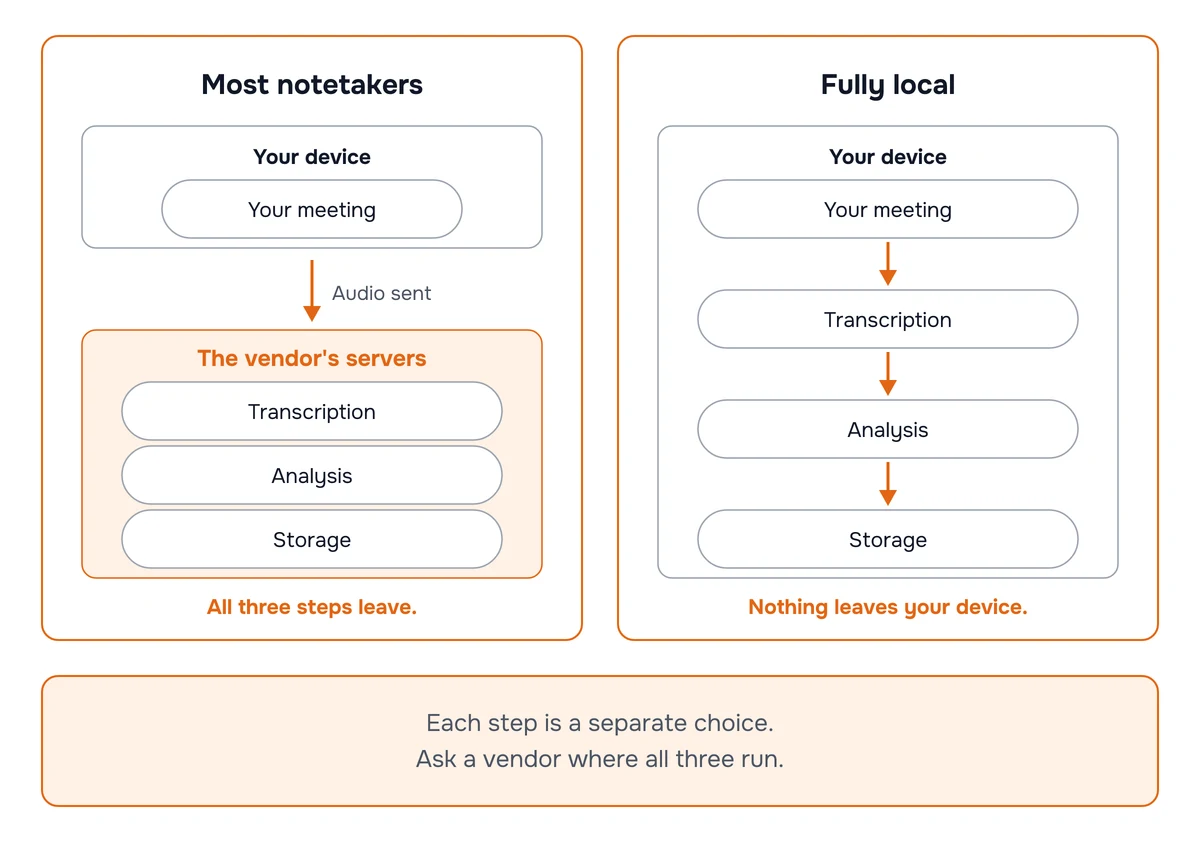
パイプライン全体をデバイス上で実行できるのか
最近のデバイスなら可能です。そして、ここが静かに変わった部分です。3つすべてを行う製品は、まだ少数です。
文字起こしは、より簡単なステップ
デフォルトのエンジンであるWhisperは、Hedyが対応するすべてのプラットフォームで動作します。Nemotronは、Webアプリを除くすべてのネイティブプラットフォームで動作します。NemotronはNVIDIAの6億パラメータの音声モデルをベースにしたストリーミングエンジンで、かつてクラウドのエンジンを選ぶ理由だった話者ラベルにも対応しています。約0.6〜0.7GBの1回限りのダウンロードが必要で、Apple Silicon Mac、iPhone XS以降、Neural Engine搭載のiPad、Windows、64ビットAndroidで動作します。精度はアクセント、室内の騒音、同時発話、専門用語によって変わるので、公表された数値ではなく、ご自身の会議で試してください。
Nemotronは、誰が何を言ったかもデバイス上で判別します。そしてHedyでは、誰かが紹介されたり名前で呼ばれたりしたときに、その話者に実名を付けることもできるようになりました。Hedy 3.12以降、対応するiPhoneとApple Silicon Macでは、セッション終了後にNVIDIAのNemotron 3 Diarizationで話者ラベルを再確認します。NVIDIAは、これがVoiceArenaの話者分離リーダーボードで1位であり、Argmaxのベンチマークでは、クラウドサービス3つを含む6つのシステムの中で最も誤りが少なかったと報告しています。この処理もデバイス上で実行されるため、話者のラベル付けのために音声をサーバーに送る必要はありません。
トレードオフがあるのは分析
ローカルAI処理は、要約と提案をお使いのマシン上で実行します。そのためにはそれなりのハードウェアが必要で、Apple Silicon Mac、性能の高いGPUを搭載したWindows PC、または最近のiPhoneやiPadです。モデルのサイズは、モバイル向けの約1.2GBから20GB超まであります。約90億パラメータの中位のモデルなら、16GBのMacで余裕をもって動きます。最大のモデルには、約25GB以上のRAMが必要です。
ローカルAI処理がデフォルトでオフなのは、クラウドでの分析のほうが速く、現時点では結果もよいからです。Hedyのデフォルトは意図的な使い分けです。音声認識はどこでもローカルにして、求めない限り音声が外に出ないようにし、分析はクラウドで行うことで、言語モデルを動かせないハードウェアでも製品がうまく機能するようにしています。クラウドなら一瞬に感じる要約が、ローカルでは30秒から数分かかることもあります。詳しい説明はエンジニアリングの詳細解説にあります。
ローカルAI処理は、黙ってクラウドに切り替わることはありません。ローカルで何かが失敗したらエラーが表示され、サーバーに対してこっそり再試行されることはありません。黙ってのフォールバックは、プライバシー機能が持ち得る最悪の性質です。防ぎたかったまさにその方向に失敗するうえ、何も知らせてくれないからです。
デフォルトと完全ローカルの中間にあたる選択肢が、もう1つあります。iOS 27を搭載した対象のiPhoneとiPadでは、分析をHedyのパートナーではなくApple Private Cloud Computeに送れます。処理はお使いのApple アカウントのもとで実行され、こちらもフォールバックしません。ただしデバイスの外に出ることに変わりはなく、Appleはリージョンを約束していないため、EUのデータ所在地要件は満たせません。EUデータ所在地が条件なら、クラウド AIにとどまってください。HedyのEUデータリージョンのアカウントでは、クラウド AIの処理はInceptronによってEU内で行われ、内容の保存や学習を排除する契約が結ばれています。
保管は機能ではなく、スイッチ
見落とされがちなのがアーカイブです。利便性の姿をして現れるからです。クラウド同期は、ほかのデバイスから見られるように、セッションデータをHedyのサーバーにコピーします。オンのままなら、ローカル処理のまま、デバイス間でアクセスできます。オフにすれば、そのセッションを明示的に共有しない限り、会話の内容が当社のサーバーに届くことはありません。ローカル処理とローカル保管は別の判断であり、前者しか提供しないツールは、パイプラインを閉じていません。
共有は、内容が外に出るもう1つの経路です。公開共有リンクは、選んだセクションをウェブページに載せ、アドレスを知っていれば誰でも、アカウントなしで開けます。音声は一切含まれず、有効期限の設定や取り消しもできますが、これは非公開ではなく限定公開です。アドレスは転送できてしまいます。機密性のある内容には、受信者がサインインしなければならないメール招待で共有してください。
メモツールの主張は、どう確かめるのか
まず挙動を観察し、それから文書を読みます。どちらか一方では足りません。
機内モードを試す。 ネットワークを無効にしてセッションを開始します。ツールが文字起こしと要約を続けるなら、ローカルの経路があるということで、それは知っておく価値があります。ただし、手がかりの1つとして扱い、証明とは考えないでください。止まった場合は、クラウドではなく、ログインやモデルのダウンロードを求めているだけかもしれません。また、オフラインで動く経路があるツールでも、再接続した途端にすべてをサーバー経由にすることがあります。ローカルモードがあることはわかりますが、オンラインのときに何が起きるかはわかりません。
話者ラベルについて尋ねる。 ツールが話者ラベルを表示しながら、デバイスの外には何も出ないと主張しているなら、どのオンデバイスのエンジンが話者分離を行っているのかを尋ねてください。名前を挙げられるベンダーは、実際のことを伝えています。挙げられないベンダーは、サーバー側でラベルを付けているのかもしれません。
再委託先リストを読む。 プライバシーポリシーは、安心させるために書かれています。再委託先リストは、調達や契約上の通知のために存在するので、経路に関わる企業の名前が載っています。Hedyのリストはtrust.hedy.aiで公開しています。どのベンダーのリストも、会議の内容を受け取り得る企業とその理由に着目して読んでください。長さだけでは、ほとんど何もわかりません。
削除後に何が残るかを尋ねる。 Fisher PhillipsのパートナーであるDanielle Kays氏は、内容が削除された後も、会議のメタデータがベンダーに残り得ること、取り込まれた内容が場合によってはモデルに記憶されたり再現されたりし得ることを指摘しました。削除の扱いはベンダーによって異なり、「削除」は「見える画面から消す」という意味であることもよくあります。
本当に重要なら、通信を検査する。 オフラインでの確認とプライバシーページは、別々の問いに答えるもので、どちらもネットワークを見ているわけではありません。規制対象の導入では、パケットやDNSの検査が、ツールが実際に何を送信しているかを観察できる確認方法です。
インストールする前に何を尋ねるべきか
質問は5つです。それぞれの答えは具体的であるべきです。
- 3つのステップは、それぞれどこで実行されるか。 文字起こし、分析、保管を、別々に名前を挙げて。「プライバシーは守られているか」ではありません。
- 話者ラベルは作成するか。どこで作成するか。 サーバー側なら、埋め込みとは何か、どれだけの期間保持されるか、参加者にどのような通知がされるかを尋ねてください。
- 保持と破棄のスケジュールはどうなっているか。 期間を明記した書面で。イリノイ州はまさにこれを求めており、後ほど引用する弁護士たちによれば、こうしたツールを導入している企業の大半はこれを持っていません。
- 再委託先はどの企業で、どこにあるか。 ヨーロッパの参加者がいる場合は、これがGDPRの問題でもあります。EUと米国の間のデータ移転をめぐる最近の動きによって、法的根拠はかつてほど安心できるものではなくなりました。
- 失敗したときにクラウドへフォールバックするか。そのことを知らせるか。 黙ってのフォールバックは、プライバシー設定を飾りに変えてしまいます。
AIメモツールの「データ保持なし」とは、何を意味するのか
たいていは、聞こえるほどの意味はありません。「ゼロ保持」は、パイプラインに関わる当事者の1つ、多くは要約を書くAIプロバイダーについての説明であり、ベンダー自身の保管やバックアップについては何も語っていません。それぞれについて尋ねてください。
AIプロバイダー。 ゼロ保持の契約とは、モデルのプロバイダーがリクエストに応えるために文字起こしを処理し、その後は何も保持しないという意味です。Hedyのクラウド AIパートナーはこの方式で、当社の契約により、お客様の内容を学習に使うことは禁止されており、リクエストが完了した後は保持されません。
ベンダー自身のサーバー。 これがアーカイブで、デバイス間のアクセスがこれに依存しているため、ほとんどのメモツールはデフォルトで保持します。Hedyが自社のサーバーにセッションデータを保存するのは2つの場合だけで、クラウド同期がオンのとき、または明示的にセッションを共有したときです。Hedyは一定の期間で自動削除することはなく、同期したセッションは、ご自身が削除するか、アカウントを削除するまで残ります。これも保持ポリシーですが、ご自身で管理できるものです。保持したくないなら、クラウド同期をオフにしてください。
バックアップ。 セッションを削除するとアプリからは消え、バックアップはそれとは別のスケジュールで後に続きます。Hedyは同期データの災害復旧用バックアップを14日間保管し、個々のセッションの復元には使わないので、削除したセッションがバックアップの中に最大2週間残ることがあります。どのベンダーにもこの日数を尋ねてください。削除がいつ最終的なものになるかがわかります。
ツールのプライバシーページがこの3つすべてに触れていない場合は、機密性のある依頼者の文書や会話を入れる前に、ポリシーそのものを読んでください。後述のHeppner事件が示すように、裁判所もそれを読むかもしれません。
Hedyで何も外に出さずに使うには
デフォルトを1つ確認し、設定を2つ変更します。
「設定」→「音声とAI」を開きます。WhisperまたはNemotronが選択されていることを確認してください。Whisperはすでにデフォルトなので、たいていの方はすでに設定済みです。誰かがクラウドのプロバイダーに切り替えていた場合にだけ、変更が必要です。
同じ画面で、「AI 処理」を「ローカルAI」に設定し、「最適なフィット ✓」と表示されたモデルを選びます。Hedyは利用可能なメモリを確認し、各モデルに「最適なフィット」「ぎりぎりのフィット」「適合しません」の印を付けるので、当て推量にはなりません。設定はデバイスごとなので、MacとiPhoneそれぞれに必要です。
次に、「クラウド同期」をオフにします。オフにすれば、セッションを明示的に共有しない限り、会議のデータが当社のサーバーに送られることはありません。
お使いのハードウェアでローカルモデルを動かせない場合は、「AI 処理」を「オフ」にしてください(選択肢の比較はAI 処理:クラウド AI、ローカルAI、オフをご覧ください)。ローカルの文字起こしは引き続き動作するので、AIによるメモなしで、非公開の文字起こしが得られます。全体の組み合わせは設定ガイドで、各構成はセキュリティのページで説明しています。
非公開のメモツールでも、同意は必要か
はい。デバイス型のツールは、ボットよりも他の人から見えにくいからです。
APは、参加者が会議プラットフォームとは別の個人用のメモ機器を使うことがあると指摘し、その場合は「ほかの出席者が、議論が記録され文字起こしされていることに必ずしも気づかない」と述べています。ボットは参加者リストに姿を現します。誰かのスマートフォンのアプリは何も現しません。そのため、こっそりした記録が容易になり、これは私たちが属するカテゴリーへの正当な批判です。電子フロンティア財団の上級セキュリティ・プライバシーアナリスト、Thorin Klosowski氏は、率直に答えています。「機微な会議の前に全員に同意を求めるのが、最も礼儀にかなったやり方でしょう。」
ローカル処理が決めるのは、データの行き先です。誰かが同意したかどうかについては、何も語りません。録音に関する法律、職場の方針、職業上の義務は、アーキテクチャが変わっても残り、誰にも見えないツールを使うなら、そのことを伝える義務はむしろ重くなります。
楽になるのは、話し合いのほうです。記録されることへの抵抗の多くは、メモそのものではなく、アーカイブに向けられています。ほかに誰が見るのか、どれだけの期間残るのか、ベンダーが買収されたらどうなるのか。「自分のノートパソコンに残るだけで、後で削除します」という説明は、「規約を読んでいないサービスにアップロードされます」という説明とは別の話になります。気まずい場面に備えて、一言一句そのまま使える同意取得のスクリプトを用意しました。法域の側面については、録音に関する法律と同意の記事で扱っています。
The Dillon Law Groupのアソシエイト弁護士、Chris Pluymers氏も、メモツールを断るときの言い回しを示しています。「この会議はAIによる録音や文字起こしツールなしで行いたいです。自分でメモを取り、よろしければ要約を共有します。」HR認定団体HRCIの最高経営責任者、Amy Dufrane氏は、個人の問題にせず組織の方針にすることを提案し、会社の方針を引き合いに出せば、個人が反対役にならずに済むとしています。
録音より文字起こしのほうがリスクが高いのはなぜか
Klosowski氏は、APの記事で最も鋭い指摘をしました。「大量の動画を保存するのは簡単ではありません。コストがかかり、探すのも大変ですが、テキストならはるかに検索しやすく、保存も安く済みます。」
AIメモツールが登場する前、録音の実質的な保護は、手間という摩擦でした。2時間の会議は、2時間分のデータです。理由がなければ誰もそれを精査せず、保管にも費用がかかるので、録音は削除されます。その摩擦は、誰も予算を組まないまま、実際にセキュリティの役割を果たしていました。
文字起こしは、それを取り除きます。テキストは、永久に保存できるほど安く、保存した瞬間から検索できます。4年分のアーカイブに1回クエリを投げれば、ある表現のすべての出現箇所が、アクセス権のある人、証拠開示命令を持つ相手方弁護士も含めて、浮かび上がります。誰も見ない録音の中で消えていたはずの発言が、検索結果になります。
ただし、危険が単純に増すわけではありません。音声には、テキストが落とすものがあります。口調、背景の会話、そして声をクローンできるだけの自分の声です。音声は後から文字起こしすることもできるので、録音とは、まだ起きていない文字起こしです。変わったのは、「誰かが見つけるかもしれない」から「誰かがすぐに見つけられる」への移行で、その差を織り込んでいた人はほとんどいません。
声紋とは何か。誰があなたの声紋を持っているのか
Pluymers氏はその仕組みを説明しました。話者1と話者2を区別するために、多くのメモツールは声ごとに音響的な特徴を導き出します。この処理は話者分離と呼ばれ、ほとんどの読者が考えたことのない部分です。
法律の現状
イリノイ州では、声紋は生体情報プライバシー法の下で生体識別子にあたり、書面による通知、目的と保持期間の開示、収集前の同意書の取得、文書化された破棄スケジュールが求められます(740 ILCS 14/15)。話者分離の埋め込みがこれにあたるかどうかは、裁判で検証されつつある新しい主張であり、確立した法解釈ではありません(Lewis Rice)。エンドツーエンド方式の話者分離の中には、そもそもこの仕組みではなく、永続的なテンプレートを作らずに、音声を匿名の話者番号に対応づけるだけのものもあります。
訴訟は現実のものです。AI会議ツールはBIPAのクラスアクションの標的になっており(Fisher Phillips)、Fireflies.aiは、登録していない人も含む参加者の声を、必要な通知、同意、保持の保護措置なしに、録音、文字起こし、保存していると主張する認定前のクラスアクション(putative class action)の被告です(Jackson Lewis)。これらは主張にすぎません。2026年8月下旬時点で、イリノイ州北部地区連邦地方裁判所の併合された訴訟は、まだ却下申立ての段階にあり、Firefliesは8月26日に応答書面を提出しました(docket)。ベンダーが声紋をポリシーに書き込む動きもあります。Fathomのプライバシーポリシー(2026年8月16日更新)には、iOSでの任意の声紋収集が記載されています(Fathom)。
盗まれた声紋にできること、できないこと
怖いほうの話が出回っているので、範囲を絞っておく価値があります。盗まれた話者分離の埋め込みが、それだけで銀行口座の鍵として使える可能性は低いです。声認証を使う銀行は自行のテンプレートを登録しており、ベンダー内部の埋め込みは、それと互換性を持つようには作られていません。実際の声のリスクはもっとありふれたもので、誰かの声を説得力のある形でクローンできるだけの録音音声が存在することです(FTC)。これは埋め込みではなく、音声についての議論です。
デバイス上の話者分離が、リスクの度合いを変える理由
デバイス上の話者分離には、役に立つ先例があります。Barnett v. Apple事件で、イリノイ州の控訴裁判所は、Face IDとTouch IDをめぐるBIPAのクラスアクションの却下を支持し、生体データは自分のデバイスから出ることはなく、Appleのサーバーに送られることもなく、機能は任意で削除できるものだったため、Appleはそれを所持も収集もしていないと判断しました(Duane Morris、IAPP)。これはローカルの話者分離とよく重なります。デバイス上で導き出され、送信されず、任意で、削除できます。HedyのNemotronエンジンはこの方式で動作し、セッション後のNemotron 3 Diarizationによる再確認も同じです。
これは免責ではありません。Barnett事件は事実関係に基づく判断で、設計や主張の仕方が違えば結論も変わり得ますし、会議を招集した人の義務については何も語っていません。これは、よい先例に裏付けられたリスクの低減であり、法的助言ではありません。
メモツールは弁護士・依頼者間の秘匿特権に影響するか
連邦裁判所は、AIが生成した文書には秘匿特権がないと判断しています。
裁判所の判断
United States v. Heppner事件で、ニューヨーク南部地区連邦地方裁判所のJed Rakoff判事は2026年2月、刑事被告人が弁護人の情報をチャットボットに入力して作成した文書は、弁護士・依頼者間の秘匿特権でも作業成果物の法理でも保護されないと判断しました。このツールは、被告のプロンプトから31の文書を生成し、そこには被告自身の弁護戦略の概要も含まれていました(Harvard Law Review)。Rakoff判事は3つの理由を挙げました。チャットボットは「明らかに弁護士ではない」こと。免責事項が出力を法的助言として扱わないよう警告しており、法的助言が主たる目的だったという主張を弱めること。そして、提供元が公表しているプライバシーポリシーが、ユーザーの情報が訴訟で共有される可能性があると警告していたため、ユーザーにはプライバシーへの合理的な期待がなかったことです(Dorsey)。
真ん中の理由は、もう一度読む価値があります。プライバシーポリシーは防御の手段ではありませんでした。証拠でした。ベンダーが自社のデータの扱いを説明するために書いた文書が、ユーザーの秘密保持への期待は合理的ではなかったとする理由になったのです。
どこまで当てはまるか
Heppner事件は、会議のメモツールが秘匿特権の放棄にあたるかどうかを判断してはいません。被告が自らの判断でチャットボットを使った事例であり、秘匿特権の対象となる会話に同席するツールではなく、この判断がメモツールに何を意味するかは、論評者の間でまだ検討が続いています(Columbia Blue Sky)。ニューヨーク市弁護士会には、依頼者との会話をAIで録音・文字起こしすることの倫理に関する正式意見があり、録音と保持を別々の問題として扱っています(NYC Bar Formal Op. 2025-6)。
より限定的なこの警告は、それでも通用します。機密資料を第三者に送ることは、それが秘密のままだという期待を弱め得るのです。経路に第三者がいないパイプラインなら、この問題は生じません。ただし、秘匿特権が生じるわけでも、証拠開示を防げるわけでも、不適切に録音された会話が適切になるわけでもありません。Daniels氏は、実務上の言い方でこう述べています。「データがほかのどこかに渡り、当事者がそれに気づいていなければ、その弁護士・依頼者間の秘匿特権の対象だった会話は、もはや秘匿特権の対象ではなくなるかもしれません。」
どの会議に完全ローカルの構成が必要か
すべてではありません。そうではないかのように言うと、助言は簡単に聞き流されてしまいます。
毎週のスタンドアップなら、クラウドのデフォルトで十分です。要約が遅くなっても完全ローカルの構成に価値があるのは、文字起こしそのものが責任の原因になる場合です。法律相談、人事の調査、取締役会や案件の協議、文字起こしに載った名前が誰かの職を左右する情報源へのインタビュー、そして、あとで医師の説明を見返すために自分の診察を録音する患者さんなどです。会議にとどまらないオンデバイスツールの全体像については、7つのローカルAIツールを比較しました。
正しい選択は、人ごとではなく、会議ごとです。ほとんどの会議はクラウドのデフォルトで構いません。文字起こしそのものが損害になり得る数少ない会議では、完全ローカルの構成で実行し、通話の前に確認し、何を使っているかを伝えてください。
よくある質問
クラウドに何も送らずにAIメモツールを使えますか?
はい。ただし、すべてのステップを自分のハードウェア上で実行できるツールは限られています。AIメモツールは、音声の文字起こし、文字起こしの分析、結果の保管という3つの処理を行い、それぞれが別々に情報漏えいの原因になり得ます。FirefliesやGranolaを含む多くのクラウド型ツールは、この3つをすべて他社のサーバーで実行します。Hedyは対応するすべてのプラットフォームで、デフォルトでデバイス上の文字起こしを行い、最近のハードウェアの多くでは分析もデバイス上で実行できます。クラウド同期をオフにすれば、セッションを明示的に共有しない限り、会議のデータが当社のサーバーに送られることはありません。
音声がデバイスの外に出なければ十分ですか?
いいえ。これは最もよくある間違いです。「音声は外に出ません」という説明が示すのは、文字起こしがローカルだということだけで、3つのステップのうちの1つにすぎません。デバイス上で文字起こしをしても、その文字起こしを言語モデルに送るツールはあります。Hedyもデフォルトではそうしています。文字起こしは発言を一言一句残した記録なので、デバイスの外に出せば、音声と同じ疑問のほとんどが生じます。マイクだけでなく、すべてのステップについて確認してください。
AIメモツールは会議参加者の声紋を作成しますか?
話者を区別するラベル付けの副産物として、作成するツールもあります。多くの話者分離システムは、声を区別するために声ごとに音響埋め込みを抽出します。その埋め込みが、イリノイ州の生体情報プライバシー法における規制対象の声紋にあたるかどうかは、確定した法解釈ではなく、訴訟で争われている段階の主張であり、すべてのシステムがこの方式というわけでもありません。自分で管理できるのは、ラベル付けをどこで行うかです。デバイス上の話者分離は、何も送信しません。Hedyは話者のラベル付けをデバイス上で行い、対応するiPhoneとMacでは、NVIDIAのNemotron 3 Diarizationによるセッション後の再確認もデバイス上で行います。
デバイス上の処理で、生体情報プライバシーのリスクはなくなりますか?
リスクは下がります。これには実際の判例の裏付けがあります。Barnett v. Apple事件で、イリノイ州の控訴裁判所は、生体データがユーザー自身のデバイス上にとどまり、Appleのサーバーに送られることはなく、機能も任意で削除できたことから、Appleはユーザーの生体データを所持も収集もしていないと判断しました。ローカル処理にとって意義のある先例ですが、判断はその個別の事実関係に基づいています。リスクの低減であって、免責にはならず、会議を招集した人の義務について何かを定めるものでもありません。
AIツールは弁護士・依頼者間の秘匿特権に影響しますか?
連邦裁判所は、AIが生成した文書には秘匿特権がないと判断しました。United States v. Heppner事件で、Jed Rakoff判事は、被告が弁護人の情報をチャットボットに入力して作成した文書は、秘匿特権の対象でも作業成果物でもないと判断しました。その理由の一部は、提供元のプライバシーポリシーに、情報が訴訟で共有される可能性があると記載されていたことです。この事件は、被告が自分でチャットボットを使ったケースであり、会議のメモツールではないため、メモツールの問題に決着をつけるものではありません。ご自身の弁護士にご相談ください。
クラウド同期をオフにすれば、メモツールは安全になりますか?
それだけでは足りません。同期が左右するのは保管であり、処理ではありません。サーバーに何も保管しないツールでも、その途中で音声を文字起こしAPIに、文字起こしを言語モデルに送っていることがあります。保管、文字起こし、分析はそれぞれ別の問題で、保管についてしか答えないベンダーは、残りの質問に答えていません。
メモツールがローカルで動いているかどうかは、どう確かめますか?
機内モードは最初の確認として便利ですが、証明にはなりません。オフラインでも文字起こしが続けば、ローカルの経路があります。止まった場合は、クラウドが必要なためかもしれませんし、単にログインやモデルのダウンロードを求めているだけかもしれません。また、オフラインで動くローカル経路があるツールでも、オンラインに戻るとクラウドを経由することがあります。オフラインの確認に加えて、ベンダーの再委託先リストを確認し、本当に重要な場合はネットワークの通信を検査してください。
デバイス上の文字起こしは、実際の会議に使える精度ですか?
日常的な会議なら十分に使えます。HedyのNemotronエンジンはNVIDIAの6億パラメータのストリーミング音声モデルをベースにしており、完全にデバイス上で動作し、誰が何を言ったかのラベルも付けます。対応するiPhoneとApple Silicon Macでは、Hedyがそのラベルを、NVIDIAがVoiceArenaの話者分離リーダーボードで1位と報告しているNemotron 3 Diarizationで再確認します。それでも精度はアクセント、周囲の騒音、同時発話、専門用語によって変わります。当社を含め、誰のベンチマークも鵜呑みにせず、ご自身の会議で試してください。
デバイス型のメモツールは、会議ボットより透明性が低いのですか?
はい。これは当社のようなツールにとって不利な点です。ボットは参加者リストに自分の存在を表示します。誰かのスマートフォンのアプリは何も表示しないので、無断で記録することが難しくなるどころか、むしろ容易になります。Associated Pressもこの点を直接指摘しました。ローカル処理が扱うのはデータの行き先であり、参加者が同意したかどうかには何も答えません。この2つは別の責任であり、後者の責任は残ります。
Hedyはデフォルトで何をクラウドに送りますか?
音声認識はすべてのプラットフォームでデバイス上で実行されるため、デフォルトでは音声は外に出ません。要約や提案を作成する分析ステップは、デフォルトではクラウドで実行され、文字起こしの内容は一時的に処理されるだけで、モデルの学習には使われません。EUデータリージョンのアカウントでは、この処理はスウェーデンのInceptronでEU内で実行されます。クラウドをデフォルトにしているのは、対応デバイスの幅と出力品質を考えた意図的なトレードオフです。ローカルAI処理を使えば分析をデバイス上に移せますし、クラウド同期をオフにすれば何も同期されません。
Hedyは会議のデータを保持しますか?
同期または共有した場合のみです。Hedyのクラウド AIパートナーは、リクエストに応えるために文字起こしを処理し、その後は何も保持しません。また、契約により、学習への利用は禁止されています。Hedyが自社のサーバーにセッションデータを保存するのは、クラウド同期がオンのとき、またはセッションを共有したときだけです。同期したセッションは、削除するまで残ります。Hedyは一定の期間で自動削除することはありません。また、同期データの災害復旧用バックアップは14日間保管されます。クラウド同期をオフにしていれば、セッションを共有しない限り、Hedyのサーバーにセッションデータはありません。
ローカル処理は追加料金がかかりますか?
いいえ。デバイス上の音声認識とローカルAI処理は、プライバシー向けの上位プランではなく、製品の一部です。無料プランには月300分が含まれ、Proは月額12.99ドルまたは年額99.99ドルです。ローカルモデルは1回のダウンロードで済み、分単位の課金はないため、完全ローカルの経路に利用料はかかりません。現在のプランは料金をご覧ください。
About the author
Julian Pscheid is the founder and CEO of Hedy AI, a real-time AI meeting coach used by tens of thousands of professionals worldwide. He writes about how AI is changing the way people prepare for, capture, and understand important conversations.



