

ローカルAI処理
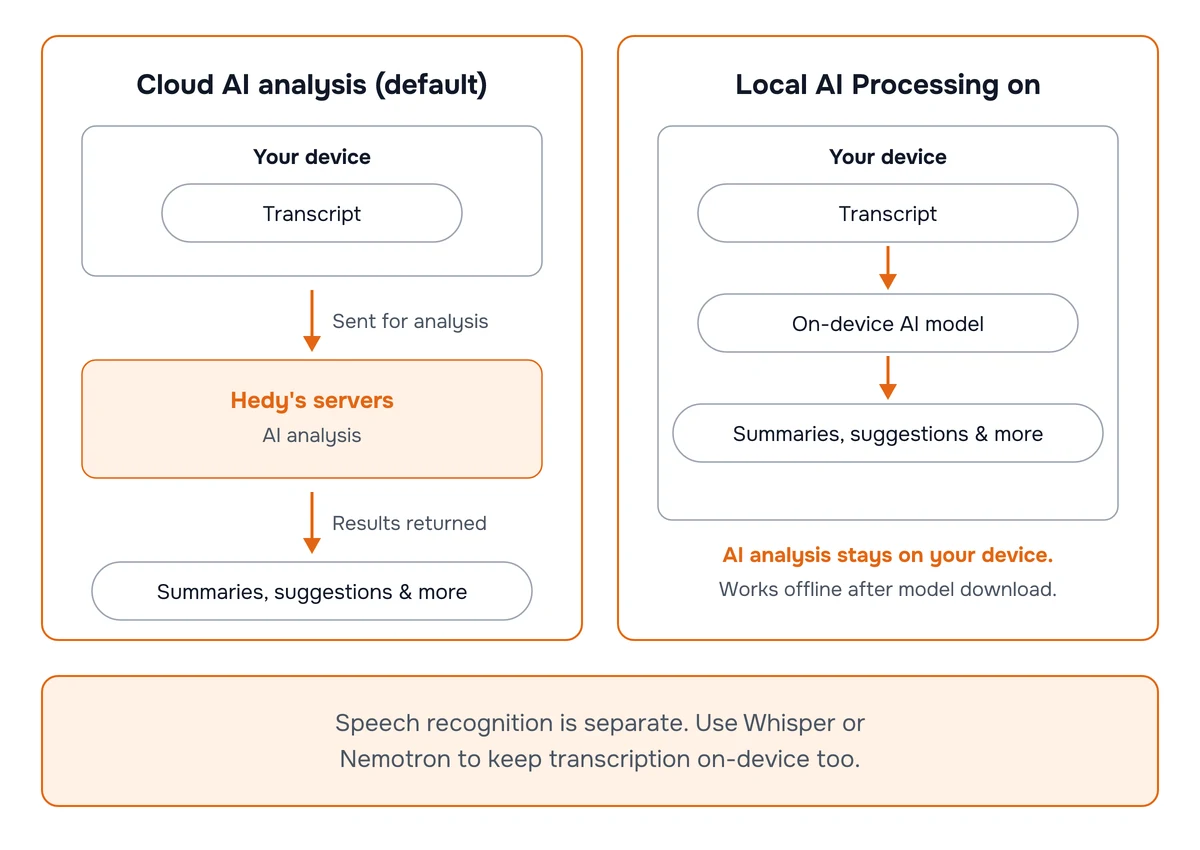
ローカルAI処理は、HedyのAI分析をお使いのデバイス上だけで実行します。文字起こしはデバイスの中にとどまり、オフラインでも動作します。
対応しているのは、macOS(Apple Silicon)、Windows(Vulkan対応のGPUを搭載)、iPhone 15 Pro以降、M系列またはA17 Proチップを搭載したiPad、対応するAndroidスマートフォンです。ローカルAIを選択すると、文字起こしを読み取ってテキストを生成するHedyの機能、つまり要約、詳細なメモ、クイックプロンプト、チャットの返信、セッション中の提案、フィードバックのすべてが、Hedyのサーバーではなくローカルで実行されます。
ローカルAI処理はオプトイン方式です。AI 処理ではデフォルトでクラウド AIが選ばれており、ほとんどの方は変更する必要がありません。クラウドAIのほうが依然として高速で、品質も一歩先を行きます。ローカルAI処理は、クラウドの構成では満たせないプライバシー要件がある方や、Hedyを完全にオフラインで動かしたい方に向けたものです。
ローカルAI処理でできること
-
セッションの要約、詳細なメモ、クイックプロンプト、チャットの返信、セッション中の提案、フィードバックのすべてを、デバイス上で動かします。
-
文字起こしをデバイス内にとどめます。AI分析のために会話データがデバイスの外に出ることはありません。
-
モデルをダウンロードした後は、オフラインで動作します。
-
クラウドベースの音声認識(Deepgram、OpenAI)を使っている場合も、共存できます。ローカルになるのは、AI分析の工程だけです。
-
黙ってクラウドにフォールバックすることはありません。ローカルで何かが失敗した場合は、サーバーに対してこっそり再試行するのではなく、エラーが表示されます。ローカルを選んだのには理由があるからです。
要件
Apple Silicon搭載のMac(M1以降)。Apple Siliconでは、CPUとGPUが1つのメモリプールを共有するため、モデルは、他に動かしているものと合わせて、システム全体のRAMに収まる必要があります。最小クラスのモデルは、最近のほとんどのMacで動作します。中位のモデル(約90億パラメータ)は、16 GBのシステムで余裕を持って動きます。最大クラスのモデルは読み込みに約25 GBのRAMが必要になることがあるため、それらには36 GB以上が現実的です。
Windows PC:最新のVulkanドライバーが必要です。ここで最も重要なのは、システムRAMではなくGPUのVRAMです。大きなモデルには、それを収められるだけのVRAMを備えたグラフィックスカードが必要です。モデルがお使いのカードにわずかに収まらない場合、Hedyは一部のレイヤーをCPUにあふれさせます。動作はしますが、かなり遅くなり、モデルの選択画面ではそうした項目に「+ 低速」の接尾辞が付きます。
iPhone 15 Pro以降、およびM系列またはA17 ProチップのiPad。スマートフォンやタブレットのメモリ制約のため、最小クラスのモデルに限られます。コンパクトなモデルは短い要約をうまくこなしますが、Macの大きなモデルに比べると、応答の幅はかなり限られます。
Androidスマートフォン:対応するGPUと、約8 GB以上のメモリが必要です。iPhoneやiPadと同じく、Androidも最小クラスのモデルに限られます。頼りにする前に、2つの点にご注意ください。Imagination PowerVRグラフィックスを搭載したスマートフォンは、グラフィックスドライバーがGPUごと巻き込んで失敗するため、対応していません。また、CPUへのフォールバックはないため、使えるGPUがないスマートフォンでは、遅く動くのではなく、ローカルAIをまったく実行できません。Hedyはお使いのデバイスを確認し、どのモデルが収まるかを教えてくれます。
オンデバイスAIを実行できないデバイスでは、すでに選択されている場合を除いて、設定 → 音声とAI → AI 処理にローカルAIは表示されません。このセクションには、「このデバイスでは、ローカルAIをまだご利用いただけません。より多くのデバイスでオンデバイスAIを利用できるよう、現在対応を進めています。」と表示されます。Webアプリでは、クラウド AIとオフが選べます。
Webアプリは、ロードマップに入っていますが、まだ対応していません。ブラウザ内でモデルを動かす際の制約のため、現時点では一貫した体験を実現するのが難しい状況です。
選んだモデルに見合った空きメモリ(Hedyが各モデルに適合度の表示を出します)と、最初のモデルのダウンロードも必要です。モデルのサイズは、選ぶモデルによって、スマートフォンでは約1.2 GBから、デスクトップでは20 GB超まで幅があります。
ローカルAI処理を有効にする方法
-
Hedyを開いて、設定 → 音声とAI → AI 処理に移動します。
-
AI 処理のドロップダウンでローカルAIを選びます。Androidでは、試験的な機能に関する通知を確認します。
-
ドロップダウンのすぐ下にある一覧から、デバイスのメモリに合ったモデルを選びます。「最適なフィット」のラベルを目安にしてください。
-
モデルのダウンロードが完了するまで待ちます。進捗とサイズ(GB)が表示されます。
-
ダウンロードが終わると、ローカルAI処理が有効になります。いつもどおりセッションを始めてください。
ローカルAI処理は、デバイスごとに設定します。MacとiPhoneの両方で使うには、それぞれでAI 処理のローカルAIを選び、モデルをダウンロードしてください。設定やモデルのファイルは、デバイス間で引き継がれません。
モデルを選ぶ
モデルの選択画面には、サイズに応じた星の評価が付いた、複数のモデルが表示されます。
-
★(星1つ) — 基本的な会議の要約や短いメモに向いています。長い会議や、込み入った追加の質問は苦手な場合があります。パラメータ数の範囲:20億〜50億。
-
★★(星2つ) — 総合的に安定しています。会議の要約、詳細なメモ、チャットを問題なくこなします。非常に長い会話や高度に専門的な会話は、難しくなる場合があります。パラメータ数の範囲:70億〜120億。
-
★★★(星3つ) — 品質がクラウドAIに近づきます。長い会議、大きなトピック、複雑なメモ、込み入った追加の質問も、安定してこなします。パラメータ数の範囲:120億超。
Hedyは、お使いのデバイスで利用できるメモリを自動的に確認し、各モデルにフラグを付けます。
-
最適なフィット — おすすめです。十分な余裕があります。
-
ぎりぎりのフィット — 動作はしますが、他のアプリを多く動かしていると、遅くなったり不安定になったりすることがあります。
-
適合しません — これは選ばないでください。
Windowsでは、レイヤーをCPUにあふれさせる必要があるモデルに「+ 低速」の接尾辞が付くため、何を選んでいるかが分かります。
迷ったら、お使いのデバイスで「最適なフィット」と表示される最大のモデルから始めてください。後から切り替えられます。モデルはダウンロード後、アプリのストレージに保存され、同じ画面からいつでも削除してディスク容量を取り戻せます。
ローカルAIとクラウドAIを切り替える
-
クラウドベースの分析に戻すには、設定 → 音声とAI → AI 処理でクラウド AIを選びます。
-
対応しているiPhoneとiPadでは、お使いのデバイスではなくAppleのサーバーで動作するApple Private Cloud Computeも選べます。AI 処理をご覧ください。
-
切り替えてもセッションが失われることはありません。既存のセッションは、現在のメモと要約をそのまま保ちます。
プライバシー
AI 処理がローカルAIに設定されている場合、文字起こしとAIが生成したコンテンツ(要約、メモ、チャットの返信、提案、フィードバック)が、AI分析のためにデバイスの外へ出ることはありません。モデルのダウンロードはHedyのサーバーから行われますが、あなたのデータは一切含まれません。
私たちのサーバーに何が流れるかは、クラウド同期もオンかどうかによって変わります。
-
ローカルAIを選択、クラウド同期はオフ。あなたが明示的にセッションを共有しない限り、会議に関する情報が私たちのサーバーに送られることはありません。音声の録音、文字起こし、要約、メモ、チャットの返信、提案は、アプリを実行しているデバイスにとどまります。保存された音声は、レコーディングをiCloudに同期をオンにした場合、Appleデバイスの外に出ることもあります。この場合、音声はあなた自身のiCloudアカウントにコピーされます。単独で動作するApple Watchのセッションは、クラウド同期とiCloud音声同期がオフでも、取り込みのために音声をペアリングされたiPhoneに送ります。
-
ローカルAIを選択、クラウド同期はオン。AI処理は引き続きすべてデバイス上で行われ、文字起こしや生成されたテキストが処理のために送られることはありません。セッションデータは、複数のデバイスからアクセスできるよう、従来のクラウド同期と同じように、(暗号化されて)Hedyのサーバーへ同期されます。
どちらの場合も、アプリが機能するために、アカウント情報、利用状況データ、クラッシュレポートは引き続き私たちのサーバーを経由します。これらに文字起こしの内容やAIの生成物は含まれません。
最も厳格な構成にするには、ローカルAI処理を、クラウド同期をオフにした状態と組み合わせ、レコーディングをiCloudに同期もオフのままにします。会話を取り込んだデバイスの中にとどめる必要がある場合は、スマートフォン、タブレット、デスクトップのアプリで直接取り込んでください。共有を行うと、そのセッションがアップロードされ、公開リンクは、選んだ部分を、アドレスを知っている誰もが開けるページに載せます。音声が共有に含まれることはありません。
音声認識は別の工程です。文字起こしにDeepgramやOpenAIのようなクラウドプロバイダーを使っている場合、音声は引き続きそのプロバイダーを経由します。両方の工程をローカルに保つには、ローカルAI処理を、WhisperやNemotronのようなオンデバイスの音声認識と組み合わせてください。音声認識プロバイダーのガイドをご覧ください。
実用的なヒント
-
長いローカルセッションでは、自動提案をオフにしましょう。自動提案は、セッションの間ずっとローカルモデルを酷使し、マシン上のほかのすべてを遅くしかねません(大量の熱も発生します)。ローカルAIを初めて選ぶと、Hedyがこの点を知らせます。
-
長いセッションでは、ノートパソコンやスマートフォンを電源につなぎましょう。デバイス上で推論を続けると、思った以上にバッテリーが消耗します。
-
ハードウェアに余裕を持って収まるモデルを選びましょう(MacとiOSではRAM、WindowsではVRAM)。「ぎりぎりのフィット」でも動きますが、ほかの作業に使える余裕が減ります。
トラブルシューティング
クラウドより応答が遅い
それは想定どおりです。クラウドなら一瞬に感じる要約が、ローカルでは、ハードウェアと選んだモデルによって、30秒から数分かかることがあります。大きなモデルほど遅くなりますが、より高性能です。
モデルがダウンロードできない
-
インターネット接続と、ディスクの空き容量を確認します。
-
Hedyを再起動して、もう一度試します。
-
数GBに及ぶモデルもあります。回線が遅いと、ダウンロードに時間がかかることがあります。
-
Windowsでは、ウイルス対策ソフトが大きなダウンロードを中断したり、モデルファイルを隔離したりすることがあります。その場合は、Windowsのウイルス対策ソフトがHedyのダウンロードやインストールをブロックするをご覧ください。
応答が非常に遅い、またはアプリの反応が鈍い
-
モデルに必要なRAM/VRAMと、デバイスの空き容量を照らし合わせて確認します。「ぎりぎりのフィット」のモデルが他のアプリと競合すると、遅くなることがあります。
-
使っていないメモリ負荷の高いアプリ(余分なブラウザタブ、バックグラウンドのアプリ)を閉じます。
-
より小さなモデルを試します。
-
Windowsでは、GPUドライバーが最新であることを確認します。ドライバーについては、Windowsで文字起こしが遅い場合の対処(GPU設定)をご覧ください。同じヒントがローカルAIにも当てはまります。
セッションの開始、インポート、結合の際に「ローカルAIモデルの準備ができていません」と表示される
これは、AI 処理がローカルAIに設定されているのに、モデルがまだダウンロードされていないため、HedyにAI出力を生成するエンジンがない、という意味です。設定 → 音声とAI → AI 処理を開いてモデルをダウンロードするか、すぐに続けるためにクラウドAIに戻してください。Hedyは現在、セッションの途中で黙って失敗するのではなく、セッションが始まる前にこれを知らせます。
「ローカルAIがモデルにアクセスできなくなりました」
以前に追加したモデルに、Hedyがアクセスできなくなっています。多くの場合、ファイルがアプリの外で移動または削除されたことが原因です。設定 → 音声とAI → AI 処理を開いて、そのモデルを削除し、もう一度追加してください。
AI機能が「利用できません」と表示される
-
モデルのダウンロードが完了したことを確認します(設定のAI 処理の下にあるモデル一覧で確認できます)。ダウンロードが中断されたモデルは、「ダウンロード済み」とは表示されなくなります。その場合は再ダウンロードしてください。
-
AI 処理を別のオプションに切り替えてから、ローカルAIに戻します。
フィードバック
AIをデバイス上だけで動かすのは新しい取り組みで、まだ初期段階です。ローカルモデルはクラウドモデルより小さいため、回答の正確さや詳しさが劣る場合があり、システムによっては、不安定さや起動の遅さに遭遇することもあります。ローカルAIが成熟するにつれて、こうしたトレードオフは小さくなっていきます。技術が許す範囲で、対応するプラットフォームを今後も広げていきます。
ご意見や問題がありましたら、support@hedy.botまでメールでお知らせください。

